Já tem algum tempo que muitas pessoas buscam informações sobre
doenças e tratamentos médicos na internet. Por mais que a prática não
seja recomendada, os engenheiros de Mountain View preferiram não ignorar a prática. Um novo algorítimo incorporado em seu sistema de busca vai permitir que o Google analise os sintomas descritos pelos usuários e forneça uma lista de possíveis doenças que eles possam indicar.
Na
prática, trata-se de uma inversão de como as pesquisas funcionavam até
agora. O método tradicional os usuários buscavam por doenças específicas
e a partir dessa informação eram exibidos os possíveis sintomas. A partir de agora, se um usuário procurar por “dor em um lado da cabeça”, por exemplo, o Google mostrará as condições relacionadas, como dor de cabeça (óbvio), gripe, sinusite, enxaqueca, ou problemas mais graves como cefaleias agudas.
Por enquanto, o novo sistema de buscas do Google só está disponível apenas nos Estados Unidos.Segundo
a empresa, a ferramenta visa reduzir a ansiedade do usuário que acordou
com uma dor de cabeça que não passa de jeito nenhum e quer saber se ele
precisa procurar um médico. Em vez de procurar em fóruns de medicina
com termos que ninguém conhece, o Google pretende entregar uma lista de doenças compatíveis com os sintomas mais comuns para, de acordo com a gravidade, “incentivar uma consulta a um médico“.
Para reforçar a seguridade das informações, o Google analisou quais são os sintomas mais procurados e se reuniu com uma equipe de médicos da Harvard Medical School (Faculdade de Medicina de Harvard) e da Clínica Mayo, um dos principais hospitais dos EUA. Por enquanto, a ferramenta só está disponível em inglês e para usuários americanos, mas a empresa promete disponibilizar a ferramenta para mais localidades em breve.
Usando a ferramenta livre / de código aberto OpenWPM, (um “framework
para medições de privacidade na web), eles conduziram uma série de
experimentos nos primeiros 1 milhão de sites do ranking de popularidade
da Alexa, e encontraram alguns resultados já esperados — concentração de
um pequeno número de gigantes mas uma “cauda longa” de milhares de trackers, prevalência desses mecanismos em sites de notícia, eficácia de extensões e plugins de bloqueio…
Mas Englehardt e Narayanan também fizeram algumas descobertas surpreendentes: a prática comum de “sincronização de cookies” entre diferentes trackers e a adoção de técnicas novas de fingerprinting para identificar dispositivos.
A
capacidade de monitorar detalhadamente as ações das pessoas na Web, a
prática difundida de compartilhar e vender dados umas para as outras e a
característica desse mercado de possuir um pequeno número de empresas
que estão presentes na maioria dos sites produzem um grave dano à
privacidade de quem acessa a Web, afetando também outros direitos
fundamentais como a autodeterminação e a inviolabilidade da intimidade.
Está
tramitando na Câmara dos Deputados um Projeto de Lei que busca trazer
garantias à população brasileira e que já têm paralelos em mais de cem países
ao redor do mundo: uma lei que proteja os dados pessoais. Se aprovada
da forma como foi proposto pelo Ministério da Justiça, ela estabelecerá
claros limites em quais dados poderão ser guardados e processados por
essas empresas com o objetivo explícito de proteger direitos
fundamentais.
Neste artigo, vamos ver as principais descobertas do
estudo de Englehardt e Narayanane entender como o Projeto de Lei nº
5.276/2016, resultado de duas consultas públicas e encaminhado à Câmara recentemente
pelo governo Dilma Rousseff antes da presidenta ser afastada, pode nos
dar maior controle sobre a coleta e o tratamento dos dados pessoais por
parte dos trackers.
Third parties e trackers: data is money, my friend
Antes de tudo, uma definição: o estudo gira em torno das third parties. Quando visitamos um determinado site, a first party (“primeira pessoa”), ele pode carregar recursos como scripts e imagens de outros domínios, as third parties (“terceiras pessoas”).
Muitos desses domínios servem trackers, enquanto outros são usados para fornecer imagens estáticas (como o gstatic.com da Google e o fbcdn.net do Facebook). Estes conteúdos não são relevantes para os propósitos do estudo, que analisa aqueles que hospedam scripts
que rodam silenciosamente, detectam e comunicam à “base” informações
sobre a visita. Para separar o joio do trigo, o estudo usou listas
usadas por plugins de privacidade, curadas e alimentadas com novos endereços de trackers conforme eles são descobertos. Para aprender mais sobre esse monitoramento funciona e como se defender dele, veja nosso artigo Trackers: os grandes stalkers da Web.
Descobertas do estudo
Embora tenham sido registradas 81.000 third parties, um pequeno grupo delas está presente em muitos sites, enquanto a maioria foi detectada em pouquíssimos sites (o “efeito cauda longa“). Isso confirma as impressões de observadores da indústria de que há uma grande concentração
de grandes empresas do ramo que domina a maior parte do mercado —
somente 123 dessas 81 mil estão presentes em mais de 1% dos sites, e
todas as cinco maiores percentem à Google. “De fato, a Google, o
Facebook e o Twitter são as únicas entidades com third parties presentes em mais de 10% dos sites”, dizem os autores.
Além disso, o estudo detectou que a maioria dos trackers faz sincronização de cookies (cookie syncing), comunicando a outros trackers os ID’s usados internamente para identificar visitantes. Esta descoberta sugere que as empresas de trackingtrocam grandes volumes de seus dados entre si por fora da interação usuário(a)↔website .
Outra descoberta pouco óbvia é que a indústria de monitoramento online pode ser uma barreira para a ampla adoção de HTTPS. Como os navegadores alertam sobre “conteúdo misto” quando um site em HTTPS carrega recursos via HTTP desprotegido, e muitos trackers
não oferecem por HTTPS (ou não por padrão), há um desincentivo para
sites adotarem essa vital tecnologia para que suas visitas não sejam
recebidas com um “cadeado quebrado”. Além dos riscos de interceptação,
um outro agravante é que tais scripts de monitoramento e seus cookies, quando trafegam via HTTP, podem ser usados por agências de inteligência e crackers para te identificar e até invadir.
Sites de notícias e outros conteúdos editoriais são os mais monitorados. Já sites de universidades, organizações governamentais e sem fins lucrativos são os que menos instalam trackers.
Uma hipótese levantada pelos autores é de que os últimos apresentam
menos monitoramento (e anúncios) pois têm financiamento externo,
enquanto os primeiros são obrigados a monetizar suas visitas (e, crescentemente, limitar visitantes que usam ad blockers).
Por que querem meus dados?
O
caminho dos anúncios desde os marketeiros até você. Cada uma dessas
empresas ajuda a definir quais você vai ver ao acessar uma página web.
“Informações pessoais são o novo petróleo, o combustível vital da nossa economia digital”, como disse Andrew Keen para a CNN.
A vasta gama de tipos de dados que os aplicativos e dispositivos emitem
constantemente — localização, relações sociais, hábitos de consumo e
comportamento — são o que mantém o capital girando para uma grande e
crescente parcela de empresas de software.
O modelo de
negócios adotado nos primórdios da rede, com serviços pagos diretamente
pelo cliente ou financiados por universidades e empresas, chegou ao
público geral como o que os especialistas em privacidade e segurança da
informação chamam de modelo de negócios da vigilância: a
empresa oferece serviços “gratuitamente”, e paga suas contas e
funcionários(as) vendendo as informações pessoais que conseguem coletar
para quem se interessa.
Esses dados possuem alto valor para uma série de outras
empresas que se beneficiam em conhecer detalhes sobre a vida das
pessoas: serviços de crédito que querem avaliar seu risco de dar um
calote, seguros de saúde que podem usá-los para determinar o valor do
plano, lojas e empreendimentos que querem entender o comportamento do
mercado e anunciar diretamente para um público-alvo específico…
Para intermediar a coleta de dados nos sites e aplicativos e seu uso final pelo mercado, surgiu a indústria das data brokers
(“corretores de dados”). Gigantes como a Acxiom e a Experian possuem
sedes ao redor do mundo, onde compram e vendem bancos de dados sobre
populações inteiras. O ramo é tão grande que muitas vezes há mais
intermediários na cadeia: centenas de outras empresas pequenas e grandes
comercializam entre si bancos de dados para integrar com sua vasta
coleção — a Experian, que comprou a Serasa em 2007, possui terabytes de informação sobre o público brasileiro e petabytes a nível global.
Algumas das data brokers que coletam dados na Internet segmentam internautas com base no seu comportamento online, justamente através dos trackers
estudados pela dupla de pesquisadores de Princeton. No Brasil, por
exemplo, uma empresa chamada Navegg Analytics busca “entender o
comportamento do consumidor”, e baseia sua segmentação da população em
um estudo de 6 anos conduzido em mais de 100 mil sites. Seus scripts estão presentes na maioria dos portais de notícias e em vários outros sites voltados para o público brasileiro.
Algumas
categorias em que a Navegg associa a você a cada visita em um site que
use seus third-party scripts. Se você não tem tempo para ler nosso artigo sobre profiling, TEM QUE ao menos ler o guia ilustrado.
E agora, quem poderá nos defender?
O
mercado de coleta e tratamento de dados em escala massiva, na ausência
de leis que o limitem e por ser invisível para quem navega no site (tanto na coleta quanto no uso), se tornou definitivamente um monstro. Proibi-lo
completamente, no entanto, é desproporcional e eliminaria uma opção
legítima de usar serviços gratuitos que, além de manterem-se
financeiramente com o tratamento de dados, os usem para aprimorar sua
interface e seu serviço — por exemplo coletando estatísticas de uso de
seus softwares para entender quais entraves as pessoas enfrentam.
O
que precisamos para tornar essa indústria mais justa e saudável são
ferramentas para que as pessoas possam exercer controle sobre que dados
vão compartilhar e entendendo o que está em jogo após suas escolhas.
Proteções legais aos nossos dados com o Projeto de Lei 5276/2016, além de eficazes no cenário atual de trackers, protegem todos os dados, quer sejam visitas em sites, quer
sejam suas compras no supermercado. Ele também traz limites claros não
só para o momento da coleta como o de tratamento (pense em algoritmos)
e o repasse para o poder público ou empresas dentro e fora do país. O
PL também obriga as empresas a seguir padrões e boas práticas de
segurança para o armazenamento, a transmissão e a anonimização (que
serão atualizados conforme as tecnologias de proteção e de quebra
evoluem).
O PL 5276/2016 protege seus dados
Segundo
Marília Monteiro, pesquisadora do Privacidade Brasil e mestranda em
Políticas Públicas na Hertie School of Governance, “há pouca, senão
nenhuma regra que regule a atividade dos chamados data brokers
no Brasil. Para aquelas que lidam com informações de crédito, algumas
balizas estão presentes nas regras consumeristas, mas isso está
limitando a alguns agentes da cadeia de informações de crédito e não de
forma sistemática e especializada”.
Nós da Coding Rights, junto
com mais 40 entidades da academia e da sociedade civil organizada
manifestamos interesse na chegada do Projeto de Lei de Proteção de Dados
Pessoais à Câmara dos Deputados. O PL nº 5.276/2016, como escrevemos em uma carta aberta, “foi construído de forma colaborativa com amplo engajamento social por meio de duas consultas públicas realizadas
no fim do ano de 2010 e começo do ano de 2015, a partir da iniciativa
do Ministério de Justiça em colocar o texto do então Anteprojeto de Lei
de Proteção de Dados Pessoais sob escrutínio público nas plataformas onlineCultura Digital e Pensando o Direito“.
O
PL de Proteção de Dados vem preencher uma lacuna na nossa legislação:
proteções semelhantes já existem na maioria das democracias mais fortes
do mundo, como a Diretiva de Proteção de Dados que orienta as leis de
cada país da União Europeia, ou as regulamentações específicas por setor
que os EUA adotam em vez de uma lei geral. Marília Monteiro, que era
coordenadora de Consumo e Sociedade da Informação da Senacon/MJ e
participou ativamente da elaboração do debate público, afirma que “o PL
5.276/16 traz padrões mínimos internacionalmente reconhecidos que criam o
dever de transparência para as data brokers. Os princípios,
direitos e garantias presentes no projeto permitiriam, por exemplo, que
os usuários acessem as informações agregadas pelas data brokers, optem pela não coleta, compartilhamento e divulgação de seus dados pessoais e que corrijam as informações a seu respeito”.
Como vimos, há uma grande concentração de atores no mercado de tracking, o que torna uma lei que estabeleça normas para sua atuação mais eficiente. Segundo os autores, “para as pouco mais de 100 third parties
que são prevalentes em pelo menos 1% dos sites, imaginamos que elas são
entidades grandes o bastante para terem seu comportamento regulamentado
por pressão da opinião pública e a possibilidade de ações legais”. Ao
longo dos últimos meses, viemos preparando uma série de materiais para
auxiliar a participação no processo de consulta pública. No guia Dados Pessoais: como contribuir para o debate público,
feito pela Oficina Antivigilância e pelo CSLab, são explicados os
principais conceitos e questões de cada um dos “eixos” do debate
conforme organizado pelo Ministério da Justiça. Fizemos um boletim especial
com artigos sobre as data brokers e os riscos e garantias da
anonimização na proteção de dados pessoais, além de uma visualização
interativa dos comentários feitos na plataforma do MJ para enxergar as
principais disputas em torno do texto da lei.
Exercendo (algum) controle sobre sua navegação
Enquanto
não temos uma lei que nos proteja, podemos exercer um maior controle
sobre os dados que entregamos para estas empresas através das já
conhecidas ferramentas de bloqueio de anúncios. O estudo dos
pesquisadores de Princeton realizou testes comparados com um navegador
com Ghostery, e verificou que ele é bastante eficiente, bloqueando grande parte dos trackers sem comprometer o funcionamento normal do site (deixando passar domínios de CDN’s e e widgets, por exemplo). As extensões Privacy Badger (Chrome, Firefox) e uBlock Origin (Chrome, Firefox, Opera)
possuem um funcionamento similar ao Ghostery, com a vantagem de serem
software livre. A combinação das duas é nossa recomendação para proteger
sua navegação dos olhos da indústria de forma transparente e
automática. Estas ferramentas atuam através de “listas negras” e
sistemas sofisticados de reconhecimento de tracking para impedir o navegador de carregar scripts enxeridos.
Comparação feita para nosso artigo sobre trackers
mostra scripts carregados sem (1ª) e com (2ª) as extensões Privacy
Badger e uBlock Origin. Muitos deles atuam em vários sites ao mesmo
tempo.
Fingerprinting, ou seguindo você na Internet sem login
Apesar
de haver ferramentas que bloqueiam os trackers tradicionais, o estudo
detectou uma série de métodos pouco conhecidos ou até inéditos de
monitorar pessoas online, que passam batido por essas extensões. As técnicas de fingerprinting permitem que o tracker
faça uma “impressão digital” de todos os dados que consegue juntar
sobre o navegador; assim, ele sabe que quem está entrando no site X é a
mesma pessoa que entrou em um site Y. Seguindo sua trajetória online
é possível aprender muito sobre seu comportamento mesmo sem saber sua
identidade pessoal — e basta fazer login em um site onde você tenha se
cadastrado e puf, já é possível te ligar ao seu histórico de navegação.
Alguns métodos de fingerprinting já são conhecidos: a lista de fontes e plugins que o navegador suporta, as informações sobre a versão do navegador (user agent string) e o tamanho de sua janela… a ferramenta Panopticlick mantida pela EFF testa o quão único é seu navegador frente aos das outras milhares de visitas que o site já ganhou.
Uma gama de outras formas de fingerprinting são menos conhecidas e estudadas. O canvas fingerprinting,
por exemplo, se aproveita de particularidades na forma como o
javascript desenha formas no <canvas> em diferentes dispositivos e
navegadores. A pesquisa de Englehardt e Narayanan é a primeira a
detectar uma série de métodos sofisticados de identificação que se
aproveitam de interações com o sistema que o javascript oferece sem
pedir permissão:
Font canvas fingerprinting é enumerar as fontes presentes no sistema através da interface “canvas” de desenho.
O WebRTC-based fingerprinting coloca na mistura seu endereço de IP na rede local.
O AudioContext fingerprinting detecta sutilezas na forma como a Audio API processa sinais de áudio em cada máquina e navegador.
Foram detectados até scripts que gravam o nível de bateria e quanto falta para (des)carregar completamente.
A princípio, estas informações parecem banais e inúteis. No
entanto, é consenso na comunidade técnica e na ciência da computação que
até mesmo poucos dados que se refiram aos hábitos ou comportamentos de
uma pessoa, quando combinados, podem identificá-las com alta precisão,
ou destacá-las na multidão com base em características coletivas como
etnia, situação econômica, condição de saúde e posições políticas.
Como disse Arvind Narayanan em seu site pessoal
dedicado à (des)anonimização de dados, “há somente 6,6 bilhões de
pessoas no mundo, então são necessários somente 33 bits de informação
sobre uma pessoa para determinar quem ela é”. O cenário só piora na Web,
já que o número de pessoas com acesso à rede é muito menor que a
população mundial, e 15 minutos de navegação podem facilmente revelar
todos os bits necessários para revelar nossa identidade.
Entramos em contato com Cooper Quintin, desenvolvedor da extensão Privacy Badger, para entender o quanto a extensão já nos protege contra as técnicas abordadas no estudo. Em vez de usar uma lista de trackers conhecidos, o software mantido pela Electronic Frontier Foundation busca em todas as third parties comportamentos associados ao monitoramento, como o armazenamento de cookies e acesso às funcionalidades do javascript que fornecem dados para fingerprinting. Assim, aprimorar a heurística do software para novas ameaças protege automaticamente milhares de usuários(as) da extensão na próxima atualização.
Para
Cooper, o relatório da dupla de Princeton é “fascinante”, e ele planeja
examiná-lo com mais calma para adaptar seu software aos novos métodos
descobertos. “Font canvas e AudioContext são definitivamente novos para mim, e não são detectados pelo Privacy Badger. No momento atual detectamos canvas fingerprinting e super cookies de armazenamento local, além dos cookies tradicionais”.
No próximo artigo da Oficina Antivigilância para a campanha #ProtejamMeusDados,
veremos como o PL 5.276/2016, através de suas determinações sobre
anonimização de dados e dados usados para formação de perfis (profiling)
nos protege de práticas abusivas de publicidade e riscos severos de
segurança que a reidentificação apresenta para todos(as), dentro e fora
da Web (spoiler: será baseado no nosso artigo sobre anonimização).
Você pode se envolver pelo Twitter , Facebook e nas suas redes de preferência — memes e materiais de divulgação estão sendo organizados no Tumblr PL 5276 protege nossos dados!. Na página especial #ProtejamMeusDados que preparamos aqui no site, manteremos uma visão geral da campanha e do processo no Congresso.
Em março de 2014, o ativista Edward Snowden denunciou a existência
de um software desenvolvido pela NSA capaz de fazer registros usando a
webcam de computadores invadidos e enviar as fotos e vídeos para a
agência de segurança americana.
No mesmo ano, o governo britânico veio a público com um alerta sobre um site russo que transmitia cenas ao vivo de centenas de webcams no mundo. E uma pesquisa de 2013 confirmou a possibilidade de se ligar a câmera de um Macbook sem que a luz que indica que ela está ativa fique acesa. Os
episódios mostram o risco de exposição indevida via webcam do
computador. A ideia de que possa existir alguém nos assistindo sem nosso
conhecimento, aliás, é digna de filme de terror.
Por isso, um número cada vez maior de pessoas está tomando uma medida simples: tapando a webcam com um adesivo ou um post-it. Agora, o problema são os microfones, que continuam expostos e podem estar sendo usados sem o nosso consentimento.
Especialistas
são unânimes: invadir uma webcam não é difícil tecnicamente. Muitas
câmeras vêm com uma senha padrão que é sempre a mesma e dificilmente é
alterada pelo usuário.
“Antes mesmo de entender que é
fácil invadir uma webcam eu já achava o olhar daquele treco invasivo,
ameaçador. Depois, virou um esforço consciente. É uma invasão muito
pessoal, porque alguém realmente pode ficar te vigiando, tem um caráter
pessoal muito assustador. Tem um potencial danoso muito grande.”
Carolina Stary
Adepta do post-it na câmera há pelo menos 5 anos
Para
aquelas já embutidas na tela do laptop, há outros métodos, como o uso
de softwares maliciosos, que abrem uma brecha no computador quando
executados e permitem acessar a câmera. O medo de um espião
invisível e silencioso por trás da webcam e do microfone não é novo, mas
tem se tornado uma preocupação do grande público recentemente. Antes disso, ativistas de direitos digitais, hackers e analistas de sistemas já usavam um post-it por cima da câmera. Mais recentemente, na cultura pop, a série “Mr. Robot”, uma das mais elogiadas
por crítica e público em 2015, escancara a facilidade com que um
indivíduo mal-intencionado pode escutar webcams ou microfones em
computadores ou celulares alheios. O crescimento da paranoia justificada
é verificável em uma breve busca no Google. Os links que ensinam
maneiras simples de acessar webcams alheias são muitos - e aqueles que
recomendam tapar a câmera, também. A maioria das pessoas, no
entanto, se esquece (ou ignora) os microfones nos computadores e a
existência de não uma, mas duas câmeras, nos celulares. Essas, quase
ninguém esconde. Uma professora de comunicação de massa da Universidade da Flórida, nos EUA, alertou recentemente
para a possibilidade real de que o Facebook esteja usando microfones de
celular para registrar áudio e coletar dados sobre o que as pessoas
estão discutindo.
“Sempre tive essa paranoia, ainda mais
porque tem gente que eu admiro e entende muito de tecnologia que usa
[post-it sobre a câmera]. Mas depois de assistir Mr. Robot, comecei a
usar o tempo todo no notebook. No celular não uso por preguiça de ficar
tirando, mas faria sentido também.”
Debora Corrano
Publicitária, em entrevista ao Nexo
A
professora disse que encontrou evidências disso falando de assuntos
específicos perto do telefone e observando o surgimento de anúncios
sobre aqueles assuntos. O Facebook diz que usa o registro de áudio
do celular apenas para identificar se o usuário está ouvindo música ou
assistindo TV, e que essa função está disponível em apenas alguns
lugares do mundo. Ainda assim, o caso não é novidade. Em 2014,
usuários descobriram uma falha no navegador Google Chrome que permitia
que um website que tivesse recebido permissão para registrar o áudio de
um computador continuasse escutando mesmo depois que o site fosse
fechado.
Para esconder as câmeras, tanto a do celular como a do computador, a recomendação mais segura é bem simples: um adesivo ou post-it por cima da lente são suficientes. No
caso do microfone, é um problema difícil de resolver. A rigor, não há
solução facilmente reversível para os microfones embutidos em laptops e
celulares. Desabilitar o programa que controla o microfone no
computador é uma possibilidade, mas isso poderia ser contornado por um
software malicioso. Outras técnicas incluem abrir o computador e
desconectar o sensor de som ou usar um chiclete ou massa de modelar para
bloquear a entrada de áudio. O problema é que essas soluções são
difíceis de se reverter quando você quiser de fato usar o microfone.
O Tor Browser, como muitos sabem, permite usar Tor no Windows, em
sistemas OS X ou Linux, sem que haja a necessidade de instalar qualquer
software. Ele pode ser executado fora de uma unidade flash USB, além de
vir com um navegador web pré-configurado para proteger seu anonimato,
contando ainda com a sua portabilidade. Portanto, vale ressaltar que Tor
Browser 6.0 já está disponível. Algumas das melhorias nessa nova
versão, incluem assinatura de código para sistemas OS X sendo
introduzida.
Isso deve ajudar os usuários que tiveram problemas com a
obtenção do navegador Tor para trabalhar em seu Mac, devido à relação
com o software Gatekeeper. Além do mais, a nova versão traz novas
melhorias de privacidade e desativa os recursos potencialmente
prejudiciais em um contexto relativo ao Tor. Há ainda o suporte
certificado SHA1 que está desativado, e o atualizador não só está
contando com a assinatura sozinho, mas está fazendo a verificação do
hash do arquivo da referida atualização, bem antes de aplicá-lo. Ainda
no contexto, a versão 6.0 do Tor fornece uma correção para uma
vulnerabilidade hijacking DLL do Windows.
A Deep Web. Sim, aquela tal camada da Internet que camufla muitas coisas
que não podem ser expostas na Surface Web, devido ao nível de
clandestinidade das transações que são firmadas, envolvendo vendas de
produtos ilícitos como drogas e armas, contratação de serviços nada
convencionais e que envolvem altas quantias em dinheiro, dentre outras
coisas que muita gente nem imagina que existe e acontece. Porém, a Deep
Web também seu lado bom como tudo nesta vida, afinal de contas, não
existe o bem e o mal em sua totalidade. Há sim, o ponto de equilíbrio. E
na tão assombrosa, temida e muitas vezes evitada "Deep Web",
encontramos coisas interessantes, edificantes, que podem aprimorar de
forma muito positiva, o nosso conhecimento. Mas chega de blá e vamos ao
ponto chave: Os endereços de email e hashes de senhas de 65 milhões de
usuários do Tumblr estão sendo vendidos on-line através de
"peace_of_mind", também conhecido como "Peace", que trata-se de um
indivíduo que, recentemente, ofereceu para venda dados de usuários do
LinkedIn, que remontam a uma violação de 2012.
As credenciais das contas roubadas de Tumblr também são antigas - de
acordo com o levantamento feito, eles foram roubados no site em
fevereiro de 2013, devido aos criminosos terem encontrado uma brecha na
segurança. Assim, a equipe do Tumblr avisou sobre isso no início deste
mês, mas esqueceu de dizer quantos usuários são afetados pelo problema.
Recentemente, um terceiro obteve acesso a um conjunto de endereços do
Tumblr de usuários com senhas e hash a partir do início de 2013, antes
da aquisição do Tumblr pelo Yahoo. Assim que se tornou ciente disso, a
equipe de segurança investigou exaustivamente o assunto. Assim, a
análise feita pode concluir que não há nenhuma razão para acreditar que
esta informação foi usada para acessar as contas do Tumblr. Como medida
de precaução, no entanto, estará sendo exigido que os usuários do Tumblr
definam uma nova senha.
A última versão Beta do WhatsApp, liberada para o Android, incorpora um novo recurso de ligações por vídeo.
A funcionalidade de Video Call pode ser encontrada na compilação Beta (v2.16.80) do WhatsApp que está disponível no Google Play.
Agora, ao fazer uma ligação, o usuário recebe o aviso de duas opções:
uma para ligação por áudio e outra por vídeo (veja os detalhes nas
imagens abaixo).
Embora já seja possível visualizar a nova função, ainda não é
possível realizar qualquer chamada neste momento, provavelmente devido a
um bloqueio “server-side”.
A Superintendência de Relações com os Consumidores (SRC) publicou nesta segunda-feira, 18, o Despacho nº 1/2016/SEI/SRC
determinando cautelarmente que as prestadoras de banda larga fixa se
abstenham de adotar práticas de redução de velocidade, suspensão de
serviço ou de cobrança de tráfego excedente após o esgotamento da
franquia, ainda que tais ações encontrem previsão em contrato de adesão
ou em plano de serviço, até o cumprimento cumulativo das seguintes
condições:
comprovar, perante a Agência, a colocação ao dispor dos
consumidores, de forma efetiva e adequada, de ferramentas que permitam,
de modo funcional e adequado ao nível de vulnerabilidade técnica e
econômica dos usuários: o acompanhamento do consumo do serviço; a
identificação do perfil de consumo; a obtenção do histórico detalhado de
sua utilização; a notificação quanto à proximidade do esgotamento da
franquia; e a possibilidade de se comparar preços
informar ao consumidor, por meio de documento de cobrança e outro
meio eletrônico de comunicação, sobre a existência e a disponibilidade
das ferramentas disponíveis acima
explicitar, em sua oferta e nos meios de propaganda e de
publicidade, a existência e o volume de eventual franquia nos mesmos
termos e com mesmo destaque dado aos demais elementos essenciais da
oferta, como a velocidade de conexão e o preço;
emitir instruções a seus empregados e agentes credenciados
envolvidos no atendimento em lojas físicas e demais canais de
atendimento para que os consumidores sejam previamente informados sobre
esses termos e condições antes de contratar ou aditar contratos de
prestação de serviço de banda larga fixa, ainda que contratados
conjuntamente com outros serviços.
As práticas de redução de velocidade, suspensão de serviço ou de
cobrança de tráfego excedente após o esgotamento da franquia somente
poderão ser adotadas após noventa dias da publicação de ato da SRC que
reconheça o cumprimento das condições fixadas.
A SRC também fixou multa diária de R$ 150 mil reais por
descumprimento dessa determinação, até o limite de R$ 10 milhões de
reais.
A determinação foi destinadas as empresas Algar Telecom S.A, Brasil
Telecomunicações S.A, Cabo Serviços de Telecomunicações Ltda, Claro
S.A., Global Village Telecom Ltda, OI Móvel S.A., Sky Serviços de Banda
Larga Ltda, Telefônica Brasil S.A, Telemar Norte Leste S.A, TIM Celular
S.A., Sercomtel S.A Telecomunicações e OI S.A.
Chegou o dia. Os planos do WhatsApp em aumentar a segurança do app
eram antigos, datam de antes da compra da startup pelo Facebook mas após
a aquisição, com o dinheiro e know-how adicionais eles finalmente foram
implementados: foi anunciado que a partir de agora, todas as
comunicações realizadas pelo aplicativo passam a contar com criptografia
de ponta de ponta, atingindo mais de um bilhão de usuários em todo o
mundo.
A mudança é simples: a partir de hoje todas as suas mensagens de
texto, voz, ligações, arquivos, fotos e vídeos compartilhados não podem
mais ser acessados por terceiros, somente por aqueles que estão trocando
informações, em comunicação individual ou em grupos.
Assim como ocorre
com o iOS e o Android (embora neste caso não seja padrão) o Facebook,
dono do WhatsApp também não tem acesso às chaves e não pode coletar nada
do que os usuários compartilham entre si, o que em tese derruba a possibilidade da empresa comercializar tais informações:
ao que tudo indica as únicas coisas que serão adquiridas pelo algoritmo
do Facebook são as informações pessoais e lista de contatos.
O recurso de criptografia já estava sendo testado há algum tempo e
vinha sendo lberado em pílulas para os usuários de Android. A partir de
agora todos os usuários nas principais plataformas serão beneficiados:
além do robozinho o WhatsApp está presente no iOS, no Windows
Phone/Windows 10 Mobile e no… não, você não, BlackBerry.
Tal atitude, além de corroborar a preocupação com a segurança que o CEO do WhatsApp Jan Koum sempre disse ter (ele
se refere constantemente ao fato de ter crescido na Ucrânia soviética,
ainda que na época da Perestroika como um dos principais motivos para
defender a criptografia e sigilo dos dados dos usuários), blindar o
app e se desfazer da chave livra a empresa de ter que se explicar para
órgãos de segurança, pois em teoria não poderiam quebrar as comunicações
nem se quisessem.
Em suma, o ato de tirar o app do ar no Brasil não adiantaria de nada já que tanto o mensageiro instantâneo quanto o Facebook não teriam como burlar a segurança. A briga agora não é mais com ele e nem com o Facebook.
Koum entende que o trabalho da polícia para combater o crime é
válido, mas dado seu histórico ele não só não pretende ser conivente
como não vai arriscar os dados de seus usuários em prol de uma
possibilidade de vigilantismo. Em suma, os interessados que se virem
para quebrar a proteção e que não compartilhem a tecnologia (embora a Apple queira saber como o FBI acessou o iPhone dos terroristas, e muito provavelmente vai ficar querendo).
Como ativar a criptografia: Caso uma das duas pontas em uma conserva particular ou um
usuário de um grupo ainda não tiver atualizado o app a conversa não será
protegida. Em caso positivo, possível verificar a chave de 60 dígitos
exibida ou se as pessoas estiverem próximas escanear o QR Code um do
outro que aparece em Informações de Contato, Criptografia. E pronto, aproveite suas conversas agora totalmente protegidas. Fonte: MeioBit via WhatsApp.
Depois de meses de trabalho, o FBI
finalmente conseguiu acessar os dados criptografados do iPhone do caso
de San Bernardino. Em uma audiência hoje, um promotor de justiça contou à
corte que o novo método para hackear o iPhone é seguro e que não é mais
necessário a assistência da Apple.
No relatório, é bem claro os avanços da equipe do FBI. "O governo foi
bem-sucedido em acessar os dados criptografados no iPhone de Farook, e
não é mais necessária a assistência da Apple." O processo efetivamente
acaba com a luta judicial que o FBI tem travado com a Apple desde
fevereiro".
O Departamento de Justiça anunciou pela primeira vez a tentativa de
acessar os dados no dia 21 de março, menos de 24 horas depois dos
rumores sobre o agendamento da primeira audiência no tribunal. De acordo
com os promotores de justiça, o método foi demonstrado pela primeira
vez às autoridades no dia 20, e foi suficientemente plausível para que o
FBI não continuasse mais no caso judicial, que foi iniciado sob a
premissa que apenas a Apple era capaz de destravar o iPhone de San
Bernardino.
O governo agendou uma reunião para reportar a efetividade da
façanha no dia 5 de abril, mas os pesquisadores do FBI parecem ter
terminado mais cedo.
O resultado é um fim abrupto a este capítulo da luta do FBI contra a
criptografia de dados. Ainda não se sabe qual é a exata natureza das
ações do governo, ou quantos iPhones diferentes tiveram que ser
destravados para que o método fosse comprovado, mas é improvável que o
governo tenha todo este poder que eles alegam ter. Isso levanta a
possibilidade de embates futuros nos tribunais ou, mais provavelmente,
ações no Congresso em relação à criptografia do tipo propostos pelos
senadores Dianne Feinstein e Richard Burr.
Em uma declaração, o Departamento de Justiça prometeu continuar seus
esforços para coletar dados de dispositivos criptografados. "Continua
uma prioridade para o governo garantir que agentes da lei possam obter
informações digitais cruciais para proteger a segurança nacional e a
segurança do público", e reiterou: "seja com a cooperação de terceiros
ou através do sistema judicial".
A Superintendência-Geral do Conselho Administrativo de
Defesa Econômica (Cade) recomendou a condenação de cinco empresas e duas
pessoas físicas por formação de cartel internacional no mercado de
placas de memória para computadores que provocou prejuízo de R$ 8,2
milhões para os consumidores brasileiros. O parecer foi publicado hoje
(28) no Diário Oficial da União.
De acordo com o Cade, as
empresas e pessoas envolvidas formaram um cartel, entre 1998 e 2002,
para diminuir a concorrência e elevar os preços de placas de Memória
Dinâmica de Acesso Aleatório (Dram na sigla em inglês). Esse tipo de
memória é utilizada por computadores para armazenar informações de forma
temporária e permitir a execução de cálculos mais rápidos pelos
processadores.
As empresas acusadas são Elpida Memory Inc.,
Hitachi Ltd., Mitsubishi Electric Corp., Nanya Technology Corporation e
Toshiba Corporation. Segundo o parecer da superintendência do Cade, o
cartel internacional causou prejuízos em cadeia ao afetar tanto
fabricantes de produtos eletrônicos quanto consumidores finais.
Informações Além dos computadores pessoais, a prática encareceu aparelhos como impressoras, modems, telefones celulares, roteadores, câmeras digitais, televisores, consoles de videogames e reprodutores de música digitais. De
acordo com o Cade, a conduta ilícita era marcada por contatos e
reuniões ilícitas entre concorrentes, tendo como principal objetivo a
troca de informações relativas à capacidade esperada, às condições de
mercado e aos preços dos produtos vendidos ao segmento de bens que usam a
memória Dram. Ao longo da investigação, alguns dos envolvidos
fecharam Termos de Compromisso de Cessação de Prática (TCCs) com o Cade,
por meio do qual confirmaram a existência do cartel e se comprometeram a
não retomar a prática.
Multa Além de
terem detalhado o funcionamento do conluio, os assinantes do TCC ficaram
obrigados a devolver ao Cade os R$ 8,2 milhões estimados de prejuízo
provocado pelo cartel. Nos Estados Unidos, houve acordos semelhantes, em
que as empresas concordaram em pagar multas para encerrarem as
investigações. Em 2010, a Comissão Europeia condenou as empresas
por prática de cartel internacional no mercado de memória Dram, com
redução de multas para as empresas que colaboraram com as investigações e
isenção de multa para a Micron, primeira empresa a denunciar o conluio. O
parecer publicado pelo Cade servirá de base para o julgamento do cartel
pelo tribunal do órgão. Caso sejam condenadas, as empresas poderão
pagar multa de até 20% do faturamento no ano anterior ao de instauração
do processo, no ramo de atividade afetado pelo cartel. A Agência Brasil está tentando contato com as empresas acusadas, mas não teve retorno até a publicação da matéria.
Uma pesquisa realizada pela AdDuplex mostra que 50% dos aparelhos Windows Phone já nas mãos dos consumidores não vão ganhar o upgrade para o Windows 10 Mobile. Entre os motivos para isso está o fato de que muitos modelos — entre eles o popular Lumia 520 — não possuem o hardware adequado para trabalhar com a nova versão do sistema operacional.
Embora
inicialmente a Microsoft tenha prometido que ia atualizar todos os
aparelhos possíveis, aparentemente a empresa mudou um pouco seu foco.
Tudo indica que a resposta às builds oferecidas através do programa
Windows Insider atualmente tem um papel essencial na hora de determinar
os gadgets que vão ganhar a nova versão da plataforma.
Publicidade
Esse é um dos motivos pelos quais aparelhos teoricamente
compatíveis com o Windows 10 Mobile, como os Lumia 920, 1020 e 1320, não
estão programados para receber o upgrade. Respondendo a comentários de
consumidores no Twitter, o vice-presidente de Engenharia de Software do
Windows 10, Gabriel Aul, afirmou que aqueles que não vão receber a
atualização final podem continuar usando a Build 10586 do software a
partir do programa Windows Insider, caso assim desejem.
Lumia 520 ainda é o aparelho Windows Phone mais popular
A
decisão da Microsoft não deve agradar muitos consumidores, visto que
grande parte deles foi convencida anteriormente de que seus aparelhos
receberiam o upgrade. Ao atribuir a “culpa” da situação à grande
quantidade de erros relatados, a empresa parece estar admitindo que não
pode — ou não está disposta a — lidar com as correções necessárias.
Segundo
a AdDuplex, o Lumia 520 detém 12,9% do mercado do Windows Phone, sendo
seguido pelo Lumia 535 (11,7%) e pelo Lumia 630 (8,6%). O aparelho
recente mais popular é o Lumia 640, que cresceu em 1% sua participação
de mercado durante o último mês.
As
pessoas interessadas em distorcer informações para favorecer objetivos
pessoais ou institucionais estão usando recursos cada vez mais
sofisticadas, o que obriga os jornalistas a serem também mais
sofisticados na identificação da manipulação de notícias.
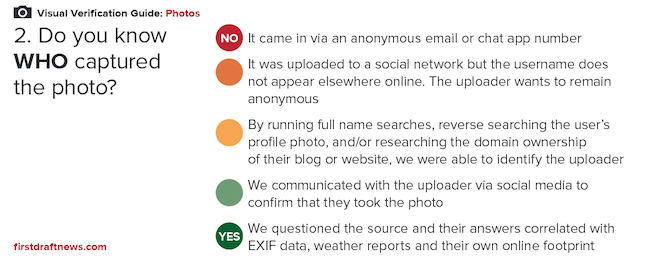
Checar
suas fontes é fundamental para qualquer investigação online. Quando você
encontra vídeos ou imagens irresistíveis, chegar ao “quem” as fez ou de
“onde” vieram é essencial. E os Guias de Checagem Visual do First Draft News
fornecem uma excelente visão de conjunto dos itens que devem ser
levados em consideração quando se pretende checar uma fonte. Há guias
especiais para checagem de fotos e para vídeos.
Reprodução de uma página do guia de verificação de fotos suspeitas
O
cenário ideal, evidentemente, é poder falar diretamente com uma fonte,
se possível, pelo telefone ou pessoalmente. Mesmo assim, podem ocorrer erros,
principalmente quando a fonte está fingindo ser alguma coisa ou alguém
que não é. Muitas vezes, essas pessoas são apenas farsantes, mas há uma
tendência crescente de casos de pessoas que usam identidade falsa para
fins fraudulentos [sockpuppets]: identidades falsas online criadas para atrapalhar determinadas pautas políticas ou sociais.
No
entanto, as fontes podem não responder quando você tenta falar com
elas. Talvez estejam ocupadas, ou talvez não queiram falar com
jornalistas. Outro motivo poderia ser que a sua fonte que a sua fonte
não seja uma pessoa coisa nenhuma: muitos casos que acontecem em redes sociais são bots [softwares concebidos para simular ações humanas repetidas vezes de maneira padrão, da mesma forma que o faria um robô].
Sockpuppets e bots
colocam alguns desafios interessantes para checagem, principalmente em
regiões do mundo onde governos os usam para manipular redes sociais (e isso significa uma parte do mundo maior do que você poderia imaginar) e sabendo como localizá-los pode poupar tempo e esforços.
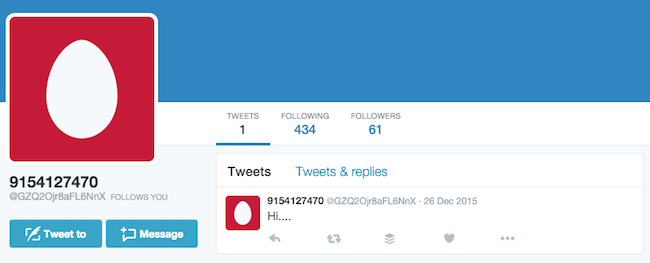
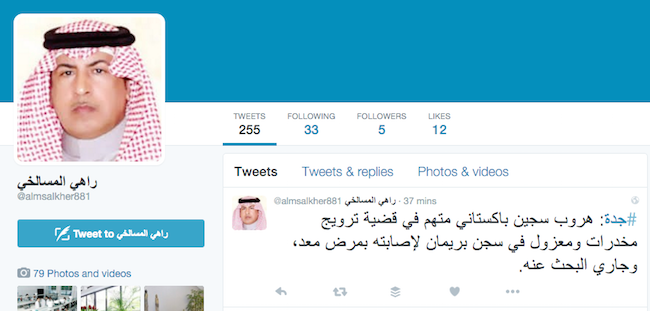
Localizando um bot Expor um caso de um bot pode ser de uma facilidade trivial ou ilusoriamente difícil. Veja, por exemplo, estas duas contas do Twitter:
No
caso do primeiro usuário, inúmeras bandeiras vermelhas aparecem
instantaneamente. O nome incompreensível do usuário, a foto do perfil do
Twitter com um ovo, o único e breve tweet – este usuário rapidamente se choca com as principais dicas para localizar contas falsas do First Draft.
No entanto, a segunda conta, cujo último tweet
fala de um preso paquistanês que fugiu de uma prisão em Gidá, na Arábia
Saudita, é um desafio mais importante. Um número razoavel de seguidores
(embora poucos) , uma boa amostragem de tweets, uma foto da
pessoa real no perfil, nomes de usuário e de visualização aparentemente
corretos e um conjunto de conteúdos (incluindo foto e vídeo) numa
linguagem que poderíamos esperar. Precisamos trabalhar um pouco mais.
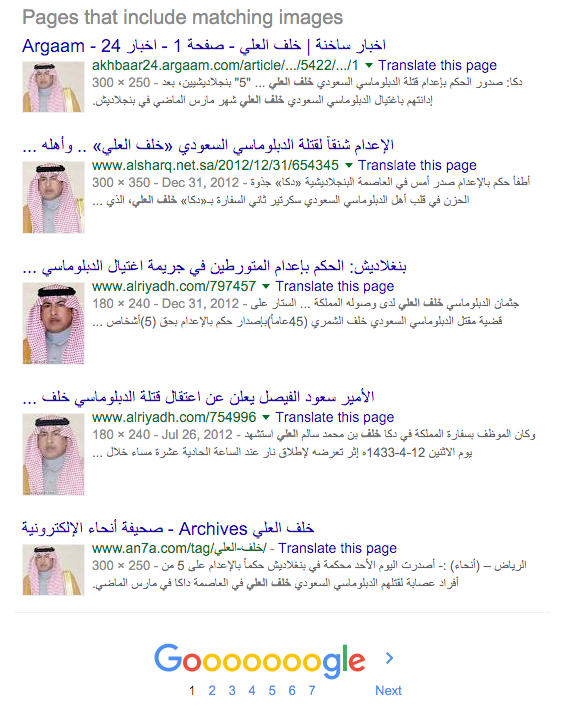
Primeiramente, vamos checar a foto do perfil. Trata-se de uma imagem original? Tentemos fazer uma busca reversa das imagens :
Reprodução da página do Google especializada na pesquisa de imagens
Uma
bandeira vermelha que surge imediatamente sugere que a foto do perfil
seja, na verdade, de um homem chamado Khalaf Al-Ali, um diplomata
saudita assassinado em Bangladesh em 2012. Portanto, talvez este usuário
tenha postado sua imagem como uma recordação do diplomata. Continuemos
investigando.
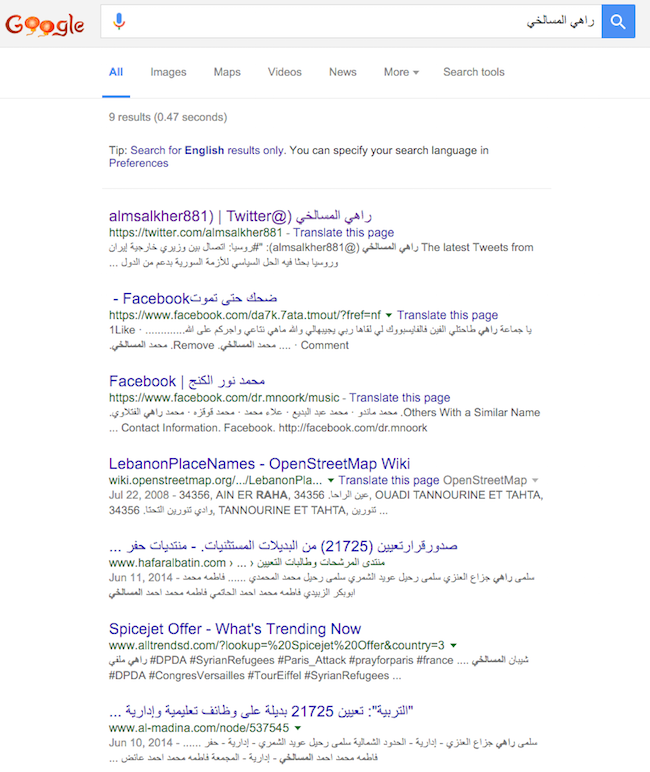
O segundo passo é ver se conseguimos encontrar uma
pessoa chamada Rahi Al-Msalkhe procurando no Google pelo seu nome no
idioma árabe. Qual o objetivo dos bots?
Não
há qualquer retorno senão a conta do Twitter que estamos investigando e
outra bandeira vermelha. Talvez esta pessoa tenha posto um nome falso
na conta? Não é tão incomum.
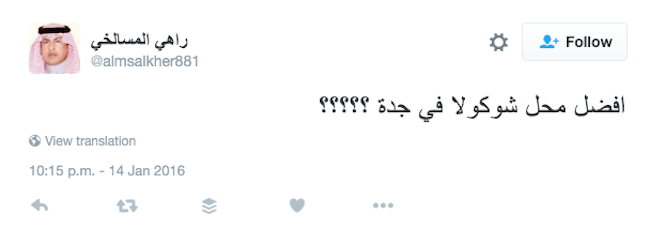
Como terceiro passo, examinemos com mais cuidado os tweets da conta. Parecem ser, em sua maioria, compartilhamento de links no idioma árabe com dois ou três tweets em inglês. Nada de extraordinário. Após uma breve busca, este tweet parece o mais pessoal e possivelmente dá uma localização: Tradução: “Qual é a melhor loja de chocolate em Gidá?????” É uma boa pergunta, mas parece que ninguém respondeu. Vejamos se alguém mais fez a mesma pergunta no Twitter.
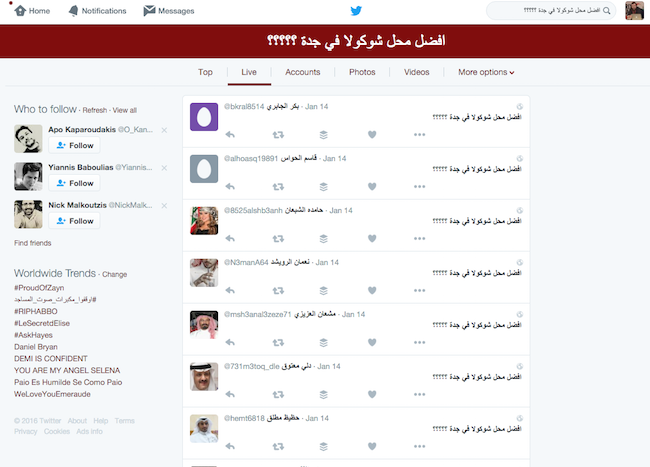
Puxa
vida! Parece que às 22:15 (horário da Costa Oeste dos Estados Unidos)
do dia 14 de janeiro, cerca de 100 contas fizeram exatamente o mesmo tweet. É difícil imaginar uma situação em que isso acontecesse na vida real e, se repetirmos a busca em dois outros tweets de @almsalker881, descobriremos que se trata de um padrão repetido.
A esta altura, podemos dizer com segurança que, na melhor das
hipóteses, esta conta está comprometida e que muito provavelmente se
trata de um bot. Ao clicar em qualquer das contas que tenha feito tweets do conteúdo duplicado, obtemos resultados semelhantes.
Esses esforços por parte de Estados podem ser mais elaborados do que você imagina. Em 2015, o repórter Adrian Chen, do New York Times, publicou uma matéria fascinante com uma visão aprofundada de uma “fábrica de trolls” russa
[um departamento aparentemente voltado para disseminar notícias e
opiniões pró-Putin nas redes sociais]. Chen rastreia algumas campanhas
de desinformação extremamente complexas que o levam de volta à fábrica
de trolls. Num exemplo, autoridades e moradores de uma cidade no
estado de Louisiana receberam mensagens com advertências sobre uma
explosão numa fábrica química e a disseminação de vapores tóxicos.
Pelo
Twitter, dúzias de contas começaram a enviar mensagens sobre a explosão,
citando jornalistas importantes com screengrabs [captura de
tela] da CNN.com mostrando as notícias “em cima da hora”. Surgiram
vídeos mostrando imagens semelhantes às do Estado Islâmico em que era
reivindicada a responsabilidade pela explosão.
Rapidamente,
apareceu uma página na Wikipedia descrevendo a explosão e fazendo o link
entre os vídeos. Tudo isto era falso, inclusive clones que funcionavam
como websites do noticiário local e divulgavam a matéria. Esse ataque de
desinformação fez-se seguir por outros, também explorando medos
públicos muito concretos, como o #EbolaInAtlanta and
#shockingmurderinatlanta.
Embora seja improvável que encontremos
campanhas de desinformação tão bem coordenadas em termos diários e
constantes, é extremamente importante que os jornalistas fiquem atentos
para as proporções em que a coleta de dados sociais pode ser manipulada e
gozem de alguns truques e ferramentas que os ajudem a localizar os bots.
Uma ferramenta útil para localizar bots é a BotOrNot, criada pelo projeto Truthy. BotOrNot analisa uma série de características de uma conta para lhe dar uma avaliação sobre se a conta parece um bot, o que inclui a rede, o usuário, “amigos”, temporal, conteúdo e análise de sentimentos. BotOrNot não é perfeito (acerta apenas em 31% dos casos de um bot selecionado), mas pode proporcionar percepções úteis sobre contas a que, de outra maneira, não teríamos fácil acesso.
A
rede social está apenas saindo da infância e a internet, na qual ela
vive, tem apenas 20 anos em termos de acesso público. Os atores
políticos utilizarão todos os meios possíveis para disseminar suas
mensagens e, portanto, é crucial que os jornalistas tenham consciência
das possibilidades e as saibam identificar.
O
cenário político brasileiro está em clima de guerra com o desenrolar
das investigações da Operação Lava Jato, realizadas pela Polícia
Federal. O que não se discute muito por trás desse processo todo são os
métodos que os agentes utilizam para adquirir dados cruciais para o
andar das apurações. Para analisar os dados contidos em aparelhos celulares dos investigados e suspeitos da Operação Lava Jato, a Polícia Federal utiliza uma tecnologia criada
por especialistas em ciência forense de Israel que realiza uma busca
total de maneira inteligente em um dispositivo móvel, recuperando todo
tipo de informação.
De última geração
Esse sistema é
utilizado não penas pela Polícia Federal brasileira, mas também por
órgãos como o FBI – a polícia federal norte-americana – e a CIA – a
agência de inteligência dos Estados Unidos, além de outros setores de
inteligência e agentes da lei no mundo todo. O sistema israelense é
capaz de extrair todo tipo de informação de um celular,
independentemente de fabricante e sistema operacional. Cerca de 17 mil
aparelhos são compatíveis com essa tecnologia de espionagem, incluindo
aparelhos “alternativos”, aqueles sem marca definida produzidos
geralmente na China e vendidos baratinhos no comércio paralelo. Essa
tecnologia consegue extrair completamente o conteúdo de um celular em
pouco tempo, além de quebra a criptografia de praticamente qualquer
senha que tenha sido configurada no aparelho. E não para por aí: até
dados já deletados do aparelho são recuperados pelo sistema. Uma
varredura completa em um smartphone leva cerca de cinco horas para ser
realizada, gerando uma grande quantidade de informações.
Procedimento minucioso
Quando
o processo de remoção de informações de um dispositivo móvel é
concluído, os agentes têm como resultado um único arquivo que contém
todos os dados extraídos. Esse arquivo pode ser armazenado normalmente,
mas só consegue ser lido por um software específico, que faz uma
varredura completa e minuciosa nas informações contidas nele. Esse
programa analisa completamente tudo que está armazenado nesse arquivo e
utiliza diversos filtros para cruzar informações retiradas de todos as
fontes de dentro do celular. Tudo é devidamente catalogado e
sistematizado para que seja consultado de maneira mais fácil pelos
investigadores. Além disso, o software também bate informações com os
dados retirados de outros dispositivos, encontrando coisas que os mesmos
têm em comum, o que pode ser muito útil em uma acareação.
Direto dos filmes
Tudo
isso pode até parecer ficção científica, coisa tirada de filmes ou
seriados policiais de investigação forense, mas não é. Na verdade, esse
tipo de programa para obter e analisar informações é mais comum do que
se imagina e ajuda bastante em investigações onde é necessário quebrar o
sigilo de informações pessoais de um suspeito. Assim, é possível
descobrir tudo sobre alguém mesmo que a pessoa tente apagar tudo.
O diário espanhol "El País" vai passar a ser "um jornal
essencialmente digital", com um foco cada vez maior no mercado
americano. O anúncio foi feito numa "carta aberta"
publicada no site do jornal, em que o diretor Antonio Caño assume o compromisso de
manter o jornal nas bancas "durante todo o tempo que for possível".
"[Chegou] o momento da transformação do "El País" num jornal
essencialmente digital, numa grande plataforma geradora de conteúdos
(…). Assumimos o compromisso de continuar a publicar uma edição impressa
do "El País" da maior qualidade durante todo o tempo que for possível.
Mas avançamos, ao mesmo tempo, na construção de um grande meio digital
de cobertura global que possa responder às exigências dos novos e
futuros leitores", escreveu Antonio Caño, no portal
do jornal.
O diretor do "El País" acrescenta que "esse meio é e será cada vez
mais americano", por ser na América que o jornal mais cresce e tem hoje
"uma expansão mais prometedora". Antonio Caño sublinha que o El País continua a ser o jornal impresso
mais vendido em Espanha e as edições digitais conseguiram nos últimos 18
meses "crescimentos espetaculares", que o tornaram "no meio de
comunicação em espanhol mais visitado e lido do mundo".
"Mas isso não significa que a batalha esteja ganha e a nossa sobrevivência garantida", acrescenta. Caño informou ainda que a "revolução" que afeta os meios de comunicação
social continua em curso e "o panorama é ainda muito confuso", apontando
que a transferência de leitores do papel para o digital é "constante".
Além disso, dentro do mundo digital, "a situação continua a ser
incerta", com os leitores a preferirem agora os 'smartphones' e com o
surgimento permanente de novos dispositivos portáteis. Somam-se "ameaças
recentes", como os bloqueadores de publicidade, e a "instalação da
cultura da gratuitidade", afirma.
Tudo isto torna "muito complexo também o horizonte no terreno dos
novos meios", sublinha ainda Antonio Caño, que justifica que as mudanças
no jornal, a poucos meses de completar 40 anos (em maio), têm como
objetivo estar "na vanguarda", garantindo que o El País está "mais vivo
do que nunca".