Mostrando postagens com marcador whatsapp. Mostrar todas as postagens

quarta-feira, 27 de dezembro de 2017

Cuidado com a utilização irresponsável das redes sociais, avisa #Obama sobre #FakeNews


Em entrevista ao príncipe Harry da Inglaterra, o ex-presidente dos Estados Unidos deixou um recado claro.


A utilização indevida das redes sociais pode distorcer a realidade e espalhar a desinformação. É a mensagem de Barack Obama, em entrevista ao príncipe Harry de Inglaterra.

O ex-presidente dos Estados Unidos pediu especial cuidado a quem ocupa posições de liderança. "Todos nós, líderes, temos de encontrar formas que permitam manter um espaço comum na Internet", defendeu. "Um dos perigos é que na rede as pessoas podem ficar numa bolha de informação que apenas reforça os seus preconceitos", destacou.


Barack Obama confessa que receia um futuro no qual os fatos podem ser descartados e onde as pessoas só leem ou ouvem aquilo que reforça os próprios pontos de vista. Obama fala mesmo no risco de "balcanização" da sociedade através da Internet.
 A entrevista foi feita pelo príncipe Harry em setembro e transmitida na BBC Radio 4. Harry confessa ter aprendido muito com a discussão de temas como as forças armadas, a saúde mental, o crime juvenil e as alterações climáticas.

Fonte: TSF RádioNotícia 

Leia : Vietnã põe 10 mil agentes para vigiar ciberespaço

terça-feira, 26 de dezembro de 2017

Putin pede que atividades cibernéticas sejam monitoradas em eleição

Vladimir Putin defende que as autoridades russas deveriam monitorizar a atividade de "algumas empresas" nas redes sociais durante a eleição presidencial de março de 2018 e avaliar a extensão do seu envolvimento na política doméstica.

De acordo com a Reuters, o presidente russo (que voltará a candidatar) não nomeou as empresas nem estava preocupado com a atividade de empresas russas ou estrangeiras. Putin defendeu esta vigilância apesar das acusações feitas à Rússia de interferência nas eleições norte-americanas que resultaram na escolha de Trump.


"Precisamos de olhar bem para como algumas empresas trabalham em Internet, em redes sociais, e até que ponto estão envolvidos na nossa vida política doméstica", disse Putin, falando numa reunião de líderes no parlamento russo. "Deve ser analisado de perto como estão a operar e estarão a operar durante a eleição presidencial."

Em Novembro, Putin assinou uma lei que permite às autoridades russas designar grupos de media estrangeiros como "agentes externos" em resposta ao que considera ser uma pressão norte-americana inaceitável sobre os media russos. Depois de serem designados, esses grupos têm de dar informação às autoridades russas sobre o financiamento, entre outros detalhes. Entre esses grupos, estão a Rádio Europa Livre/Rádio Liberdade e Voz da América, ambos apoiados pelos EUA.

Putin poderá voltar a ser eleito em março e governar até 2024, o ano em que fará 72 anos de idade. O presidente russo domina o país há 17 anos.

Alexei Navalny, o líder da oposição na Rússia, foi hoje impedido pela comissão eleitoral russa de competir contra Putin. Consideraram que ele não era susceptível de concorrer devido a uma pena de prisão suspensa.   


Fonte: Sabado.PT                             

A pornografia substitui a educação sexual ?


Os adolescentes urbanoides dos anos noventa não podiam entrar em discotecas de tênis. Esperavam a bênção do porteiro de plantão na entrada com seus náuticos e botas de laços. Tampouco sem a carteira de identidade. Isso se tivessem a idade permitida, porque muitos usavam o RG do decano do grupo com a esperança de não serem barrados, enquanto o resto cantava a plenos pulmões Zombie, dos Cranberries. Falamos de uma época sem acesso à Internet, sem tablets, sem telefones celulares e, em muitas casas, sem um PC, essa rara avis que arrebatou os corações dos mais freaks da classe, mas que nem todas as casas podiam dar-se ao luxo. Ainda é assim.


Naquela época, era difícil imaginar que poucos anos depois apareceriam plataformas como YouTube e Facebook que mudariam a maneira de se relacionar dos jovens de gerações futuras. Assim como a maneira de flertar e descobrir a sexualidade. Quando o século XXI estreou, os adolescentes já não tinham que decifrar a pornografia codificada do Canal Plus nem se contentar com as fotografias da revista do vizinho ou as que anos antes eram baixadas ao ritmo dos roteadores de 56kb. A popularização da Internet e dos novos dispositivos tecnológicos que chegaram com a virada do século já lhes abria o caminho para um acesso maior (e mais rápido) a conteúdos sexuais e pornográficos e, com eles, a uma mudança na maneira de se relacionar também entre eles em nível afetivo e sexual.Snapchat, acusado de expor crianças a “conteúdo sexual explícito”

Expostos à hiperssexualização e aos estereótipos
“Todos carregamos um smartphone no nosso bolso. A informação está ao nosso alcance em milissegundos e, qualquer coisa que possamos fazer, conseguimos muito mais rápido, de forma mais simples. Isso acontece quando se trata de obter informações sobre qualquer assunto, de nos comunicarmos e, claro, de ‘fazer o bem e fazer o mal’”, afirma Nayara Malnero, psicóloga, sexóloga e autora de 'Sexperimentando': Aprende y Disfruta' (Editora Planeta), para quem já não é surpresa quando, em qualquer classe de ensino secundário, pergunta: "Como se paquera?" e sempre há alguém que responda: "Pelo Instagram".

Viver em uma sociedade tão tecnológica como a atual torna inevitável que todos os adolescentes tenham acesso ilimitado à rede. Com as vantagens que isso implica, mas também com seus riscos, porque, para Malnero, o ponto crucial é como essa democratização da tecnologia se encaixa com a hiperssexualização na qual estamos imersos. "Nosso entorno hiperssexualizado utiliza a sexualidade como meio de venda, como forma de humor e, poucas vezes, como meio de educação ou aceitação. Todos acreditamos que sabemos muito sobre sexo, todos nos expomos (ou somos expostos) a situações sexualizadas e, no entanto, poucos de nós contamos com recursos suficientes (informações, habilidades, autoconfiança) para enfrentá-las", lamenta.

Segundo Malnero, essa hiperssexualização também tem como consequência uma antecipação no interesse por sexo: "As crianças cada vez mais perguntam antes e, claro, também encontram as respostas antes. E, obviamente, no Google nem sempre encontram as mais apropriadas". E se não perguntam dá na mesma, porque na tenra idade de 9 anos uma porcentagem elevada de crianças já tropeçou acidentalmente em conteúdo adulto enquanto navegava na rede.

Conteúdo que distorce o que é o sexo e que implica estereótipos de gênero e práticas sexuais violentas não consentidas. Algo evidente para Mar Cubero, psicóloga e coordenadora do projeto “Sem Gênero de Dúvidas”, focado na prevenção da violência sexual e de gênero entre adolescentes e desenvolvido pela Fundação para a Convivência (ASPACIA). Cubero se mostra preocupada não só porque os jovens consumam pornografia cada vez mais cedo e tenham maior acesso, mais rápido, livre e "com muito menos filtro" do que as gerações anteriores, mas também pelo modelo de relacionamento que está sendo transferido. "Nos workshops que fazemos com adolescentes, vemos relatos de casais adolescentes em que as garotas não entendem por que enfrentam violência sexual por parte de seus parceiros; e o que eles verbalizam com normalidade é: ‘É disso que elas gostam’. 

A pornografia traduz um modelo de relação desigual em que a mulher cumpre uma função de objeto sexual disponível para o homem e onde são perpetuados estereótipos de gênero levados ao extremo: o homem é aquele que tem o desejo sexual permanentemente, e a mulher é quem responde a esse desejo masculino. Isso, ao final, faz com que as primeiras experiências dos adolescentes sejam muito marcadas por essa ideia", explica Cubero.

A ficção científica da sexualidade humana

"Eu chamo a pornografia de ficção científica da sexualidade humana", critica com humor Nayara Malnero. Para a autora de 'Sexperimentando', o problema é que não existe um forte compromisso com a educação sexual na Espanha, nem do sistema educacional nem da maioria das famílias. 

"Segundo um estudo do portal pornográfico Pornhub, a grande maioria das crianças já esteve em contato regular com conteúdo pornográfico ao chegar aos 11 anos. Os jovens usam a pornografia como um substituto da educação sexual e, embora seja melhor que nada, você pode imaginar aprender a dirigir com base em como Bruce Willis faz isso em seus filmes de ação? Pois é exatamente o mesmo", acrescenta Malnero, para quem os pais são os que devem combater isso “por meio da prevenção, da educação, disponibilidade para o que precisam e dar a resposta para todas suas dúvidas". Em suma, "criar um bom clima de naturalidade" para o diálogo.


Em 2014, o workshop com adolescentes Consent Cookies: A Confidence-Building Workshop for Teens, da educadora sexual Yana Tallon-Hicks, tornou-se popular em muitas escolas norte-americanas pela mudança proposta em suas aulas: Tallon-Hicks concentra seus workshops na busca do lado positivo do sexo, com base no sexo consensual e prazeroso, e não no lado negativo ou no medo. Em maio de 2016, Tallon-Hicks foi convidada a falar sobre seu trabalho como educadora sexual na TEDxVienna, onde abordou temas como a educação sexual moderna, a importância do consentimento e o que a pornografia convencional agrega ao debate para os jovens, levantando a questão destacada por Malnero, de que se a pornografia é o nosso "novo educador sexual".

Fonte: EL PAIS

Os perigos da radiação do celular para a saúde

Aparelhos móveis são considerados possivelmente cancerígenos para humanos e Califórnia recomenda minimizar uso

Riscos do celular para a saúde
Os reais efeitos da radiação do celular sobre o corpo humano ainda não são totalmente conhecidos - e parecem ser cada vez menos estudados à medida que os aparelhos se popularizam. O celular emite uma radiação eletromagnética a partir da antena acoplada ao aparelho (que atualmente não é visível, mas faz parte de seu mecanismo interno). Essa radiação tem uma frequência alta e, como o celular é um aparelho usado muito próximo ao corpo, em especial à cabeça, a maior parte dessas ondas são totalmente absorvidas pelo corpo humano.

Há estudos que relacionam o uso dos dispositivos móveis com o aumento do metabolismo da glicose cerebral e também com a incidência de tumores malignos no sistema nervoso central. O risco é ainda maior para crianças, que utilizam os aparelhos cada vez mais cedo, ficando exposta à radiação em uma fase de formação do cérebro. Leia mais sobre as pesquisas realizadas na área na matéria: “Ondas eletromagnéticas de celulares e antenas podem prejudicar a sua saúde. Veja dicas para se prevenir”.

Com base nas pesquisas já existentes, a Agência Internacional de Pesquisa sobre Câncer (IARC, na sigla em inglês) classificou o campo magnético emitido pelos celulares como possivelmente carcinogênico para humanos. Ou seja: a radiação interfere na saúde do ser humano, mas ainda não há evidências suficientes para classificá-la como carcinogênica para humanos.

Embora os governos e empresas de telefonia demonstrem pouquíssimo interesse em realizar e divulgar novas pesquisas na área, o Departamento de Saúde da Califórnia lançou agora em dezembro de 2017 um guia para que as pessoas minimizem o uso dos celulares. O documento é resultado das pressões feitas pelo pesquisador de saúde pública Joel Moskowitz, da Universidade de Berkeley, que moveu um processo contra o Departamento de Saúde Pública da Califórnia por negar informações de interesse público. Detalhe: o guia estava em andamento desde 2009, teve várias versões escritas em 2015 e depois ficou estagnado.

Agora que veio a público, as autoridades da Califórnia se mostram preocupadas com a exposição precoce de crianças à radiação, com os riscos de tumores cerebrais e câncer de nervos relacionados à audição, tumores nas glândulas salivares, baixa contagem de esperma ou menor mobilidade, dores de cabeça e efeitos na aprendizagem e memória, além das interferências no sono. Moskowitz já alertava para esses fatores, que são uma possibilidade em pessoas que usam o celular de modo muito intenso, há anos.

Algumas recomendações contidas no guia californiano de como evitar exposição à radiação dos celulares são: deixar o aparelho longe do corpo, de preferência na bolsa ou mochila; usar fones de ouvido e autofalante, para evitar a proximidade do aparelho com o cérebro; preferir o envio de mensagens a ligações; evitar usar o celular quando o sinal está fraco, pois o dispositivo emite mais ondas de radiação nessas circunstâncias; evitar streamming de áudio ou vídeo, preferindo o download dos arquivos; e não dormir com o celular perto da cama, mantendo-o a uma distância mínima de pelo menos um braço - se quiser o aparelho perto, deixe-o desligado ou em modo avião.

Para entender mais sobre o assunto, confira o vídeo de uma palestra do professor Joel Moskowitz sobre os riscos dos celulares e redes wi-fi para a saúde.


Fonte: Ecycle 

Leia:

Mantenha seu celular longe do corpo

segunda-feira, 25 de dezembro de 2017

Como ensinar programação para as crianças

Podemos contar com alguns recursos para que as crianças iniciem, de forma fácil e divertida, no mundo da programação. Um exemplo disto são os jogos online encontrados na plataforma de Tynker. Existe 8 jogos dedicados a este projeto, levando em conta diferentes idades e nível de conhecimento.


Os jogos gratuitos também oferecem suficientes opções para que as crianças escolham um tema de seu interesse e a experiência seja mais agradável para elas. Por exemplo, alguns puzzles têm como protagonista um cachorrinho que viverá diferentes aventuras a medida que se desenvolve o jogo.

Se, por outro lado, a criança preferir o tema espaço, há dois jogos dedicados à ele, são Lost in Space e Space Zombies. Também há desafios interessantes que permitem construir formas ou descobrir objetos mediante um ambiente de programação em blocos, desenvolvendo suas habilidades.

Para acessar os jogos, não é preciso registro, basta simplesmente escolher a atividade que a criança deseja e seguir as instruções. E um detalhe para os pais ou professores que optarem por implementar estes jogos, é que cada um deles contém um breve resumo dos conceitos e habilidades que a atividade pretende ensinar.

Fonte: Ensino

terça-feira, 28 de novembro de 2017

FAKE NEWS: Ministro da Educação Mendonça Filho aciona Polícia Federal contra notícias falsas


O ministro da Educação, Mendonça Filho, solicitou à Polícia Federal que investigue a disseminação de fake news (notícias falsas) na internet sobre uma suposta orientação do Ministério da Educação a prefeitos e governadores para reduzirem salários de professores da educação básica pública de todo o país. A notícia falsa propagada por um blog do Piauí é atribuída ao diretor de comunicação do Sindicato dos Trabalhadores em Educação Básica daquele estado, João Correia.

“Fake news é um desserviço à população e à democracia”, advertiu Mendonça Filho. “É inaceitável que, para atender interesses outros que não os da sociedade, um site produza uma informação errada para gerar tumulto e insegurança entre os professores do Brasil. ”O ministro também pediu a Advocacia Geral da União (AGU) que ingresse com pedido de resposta ao blog Dever de Classe, onde a falsa notícia foi publicada.

O ministro informou que o piso salarial profissional nacional para os profissionais do magistério público da educação básica está garantindo pela Lei n° 11.738, de 16/7/2008. “Em janeiro deste ano, anunciei o aumento de 7,64% no piso salarial, que representou incremento de 1,35% acima da inflação acumulada de 2016, de 6,29%, conforme o Índice Nacional de Preços ao Consumidor (IPCA), do Instituto Brasileiro de Geografia e Estatística (IBGE)”, lembrou Mendonça. “O reajuste anunciado segue os termos do art. 5º da Lei nº 11.738, que estabelece a atualização anual do piso nacional do magistério, sempre a partir de janeiro. Para este ano, o piso nacional do magistério é de R$ 2.298,80.” O professor que tem carga horária mínima de 40 horas semanais e formação em nível médio –modalidade curso normal – não pode receber menos do que esse valor.

O ministro afirmou, ainda, que os estados e municípios que, por dificuldades financeiras, não possam arcar com o piso, devem contar com a complementação orçamentária da União, como determina a Lei 11.738/2008, no art. 4º. “Estamos antecipando o repasse de recursos do Fundo de Manutenção e Desenvolvimento da Educação Básica e de Valorização dos Profissionais de Educação (Fundeb) para complementar o piso salarial dos professores, nos estados e municípios”, destacou. “O pagamento está sendo feito mensalmente, desde janeiro.”

O blog Dever de Classe, de onde partiu a informação falsa sobre redução de salários, está registrado como sendo do mesmo autor de outra fake new, veiculada em setembro de 2016, sobre suposta decisão do MEC de acabar com as regalias dos professores pata equilibrar os cofres dos estados e municípios. A primeira notícia falsa foi veiculada no site midiapopular.net, que foi obrigado, por decisão da Justiça, a dar direito de resposta ao MEC.

O ministro reafirmou que adotará as medidas judiciais cabíveis.

Assessoria de Comunicação Social do MEC

quarta-feira, 11 de janeiro de 2017

Criptografia: O que é um mensageiro privado


Então, o que é um mensageiro privado? Muitos diriam apenas que um aplicativo de mensagens é privado se as mensagens que transmite são criptografadas.

Mas, na realidade, a privacidade de mensagens é muito mais complexa do que isso. No congresso Chaos Communication, Roland Schilling e Frieder Steinmetz deram uma palestra na qual explicaram em palavras simples o que é um mensageiro privado e quais atributos um aplicativo de mensagens deve ter para ser considerado privado.
 
O que é um mensageiro privado?

Os seis pilares da conversa privada

Para entender a ideia de mensagens privadas, Schilling e Steinmetz sugerem que imaginamos tentar ter uma conversa particular em uma festa. O que fazemos para tornar essa conversa privada? Nós provavelmente encontrar um quarto isolado, onde ninguém, mas a pessoa que queria falar com poderia ouvir.
 
Isso é a primeira coisa sobre conversas privadas: se eles estão acontecendo cara a cara ou on-line, eles têm que ser confidenciais . Nenhuma outra pessoa além de você e seu parceiro de comunicação deve ser capaz de ouvir o que você está falando.
 
A segunda coisa é a autenticidade - você tem que saber que a pessoa que você está falando é na verdade a pessoa que você pretende falar. Na vida real, você reconhece o rosto da pessoa, mas com mensagens on-line, isso é mais complicado.
 
Se a conversa é realmente importante - e as conversas privadas geralmente são - você quer ter certeza de que seu parceiro de conversa ouve cada palavra que você diz, e vice-versa. Mais do que isso, você quer ter certeza de que a pessoa ouve exatamente o que você diz. Em outras palavras, para mensagens privadas on-line, você precisa saber que algum terceiro não corrompeu suas mensagens. E esse é o conceito de integridade , que também é crítico para mensagens privadas.
 
Vamos agora imaginar que um terceiro entrou na sala e ouviu uma parte de sua conversa. Em uma conversa na vida real, esse terceiro saberia apenas a parte da conversa que eles estavam realmente ouvindo, não o que você estava falando antes que eles vieram ou depois que eles saíram. No entanto, a Internet nunca esquece, e comunicação on-line não é tão simples como off-line. Isso nos leva a dois conceitos mais importantes por trás da mensagem privada: o sigilo  
Futuro e o sigilo futuro .
 
Em uma conversa na vida real, esse terceiro saberia apenas a parte da conversa que eles estavam realmente ouvindo, não o que você estava falando antes que eles vieram ou depois que eles saíram.  
O segredo direto não permite que o terceiro saiba tudo o que você discutiu com seu parceiro de comunicação antes de entrarem na sala, e o sigilo futuro não permite que o terceiro saiba o que você falou depois que eles saíram da sala.

Digamos que o tema que você estava discutindo era realmente delicado. Neste caso, se alguém o acusou de dizer alguma coisa sobre o assunto, você pode querer negá-lo. Se a conversa era privada, as únicas pessoas que podem citá-lo são você e seu parceiro de comunicação, então é a sua palavra ("Eu não disse isso!") Contra a deles ("Você disse isso!"). Nesse caso, ninguém pode provar nada, e isso nos leva ao importante conceito de negação .

Implementação da privacidade em mensageiros

Então, esses são os seis recursos que precisam ser implementados em um aplicativo de mensagens antes de podermos chamá-lo de privado. Eles são bastante fáceis de alcançar quando estamos falando sobre uma vida real, cara a cara conversa privada, mas quando se trata de serviços de mensagens há sempre um terceiro - o serviço em si. Como são os seis pilares implementados com este terceiro em mente?
 
A confidencialidade é mantida através do uso da criptografia. Existem diferentes tipos de criptografia, simétrica e assimétrica, ou seja, criptografia de chave pública . Mensageiros privados (neste caso, Schilling e Steinmetz revisaram Threema como exemplo) usam ambos, criando uma chave compartilhada da chave pública de uma pessoa e da chave privada da outra pessoa. Ou a chave privada da primeira pessoa é a chave pública da segunda pessoa - a matemática por trás da criptografia funciona da mesma maneira.
 
Portanto, a chave é idêntica para ambas as pessoas e única para os dois (nenhum outro par recebe a mesma chave). O aplicativo gera a chave independentemente e mantém a confidencialidade ao não transferi-la - ambas as pessoas têm direito depois que decidem conversar entre si.
 
O aplicativo gera a chave independentemente e mantém a confidencialidade ao não transferi-la - ambas as pessoas têm direito depois que decidem conversar entre si.  
Esse método também é usado para garantir a integridade - uma parte externa adicionando algo ao texto já criptografado tornaria ilegível. Nesse caso, seu parceiro de conversa receberia o que você enviou ou uma mensagem de erro (porque o mensageiro não poderia descriptografar o texto cifrado).
 
Para ainda maior confidencialidade, você pode querer esconder o fato de que você e seu parceiro de conversa falou um com o outro em tudo. Outra camada de criptografia cuida disso. A mensagem enviada é criptografada usando a chave compartilhada do seu parceiro de conversação - é como envolver a mensagem em um envelope, com um endereço nele. E então você criptografá-lo mais uma vez - colá-lo em outro envelope e enviá-lo para o endereço do servidor do mensageiro. Nesse caso, você usa a chave gerada com base na chave e na chave do servidor.
 
Portanto, este envelope dentro de um envelope é entregue ao servidor de mensagens. Se um atacante em potencial tentar olhar para ele, eles sabem que você o enviou, mas não o seu destino final. O servidor de messenger desenrola o envelope externo, vê o endereço de destino (não a própria mensagem), envolve o pacote em outro envelope e envia-o para o destinatário. Neste ponto, um invasor potencial pode ver apenas um envelope do servidor de messenger para o destinatário, mas não onde ele se originou.
 
Com um monte de envelopes voando em todas as direções, é difícil rastrear qual pessoa recebeu sua mensagem. Duro, mas não impossível: Se alguém fosse pesar todos os envelopes, eles poderiam encontrar dois envelopes do mesmo peso exato e associá-lo com seu parceiro de conversa. Para garantir que não pode acontecer, o sistema adiciona um peso aleatório para cada envelope, de modo que o envelope que você enviou eo envelope que seu parceiro recebeu nunca pesam o mesmo.
 
Para garantir que não pode acontecer, o sistema adiciona um peso aleatório para cada envelope, de modo que o envelope que você enviou eo envelope que seu parceiro recebeu nunca pesam o mesmo.  
É mais difícil manter a autenticidade . Alguns aplicativos de mensagens usam endereços de e-mail ou números de telefone como IDs de usuário - essa é a maneira como o usuário prova que ele é quem afirma ser. No entanto, os números de telefone e os endereços de e-mail são dados confidenciais que talvez você não queira compartilhar com o aplicativo. Alguns - como o Threema - encorajam os usuários a usar uma ID diferente e trocar códigos QR para provar sua identidade.
 
Deianbility neste caso é conseguido através do envio de cada mensagem para ambos os participantes do diálogo. A chave é a mesma para ambas as pessoas, portanto, ou poderia ter enviado a mensagem. Portanto, mesmo que alguém consiga interceptar e descriptografar a mensagem recebida, eles não podem ter certeza de quem a enviou.
 
Que cuida da confidencialidade, autenticidade, integridade e negação. E quanto ao sigilo futuro e futuro? Se a chave privada e a chave pública de uma pessoa forem sempre iguais, se a chave compartilhada for comprometida, o invasor poderá descriptografar as mensagens anteriores e futuras.
 
Para limitar isso, as chaves devem ser periodicamente reeditadas pelo servidor. Se a chave for reeditada, digamos, uma vez por mês, um invasor só poderá ler o histórico de conversações para este mês e perderá a capacidade de monitorar a conversa uma vez que uma nova chave for emitida (na prática, a reedição acontece muito mais frequentemente) .

Embrulhar

Assim termina nossa breve introdução ao conceito de mensagens privadas. Na verdade, é muito mais complicado, porque os aplicativos de mensagens modernos precisam lidar com arquivos de mídia, bate-papos em grupo e, às vezes, até com chamadas de vídeo.
 
Se você estiver interessado em aprender mais, sugerimos que assista a este vídeo abaixo de 33C3. Nela, Schilling e Steinmetz explicam não só as idéias básicas, mas também falam sobre como eles têm Threema de engenharia reversa e descobriram como ele implementa os principais princípios de privacidade. Nós apreciamos o vídeo e espero que você também.


Fonte: Kaspersky Lab by John Snow 

Leia também:

Signal, mensageiro indicado por Snowden, chega para PC


O que é Criptografia 


terça-feira, 21 de junho de 2016

Estudo de Princeton expõe vigilância descontrolada dos trackers na Web

Os pesquisadores Steven Englehardt e Arvind Narayanan, da Universidade de Princeton, publicaram no dia 18 de maio o “estudo mais amplo e detalhado de monitoramento online até a presente data” (paper).

Usando a ferramenta livre / de código aberto OpenWPM, (um “framework para medições de privacidade na web), eles conduziram uma série de experimentos nos primeiros 1 milhão de sites do ranking de popularidade da Alexa, e encontraram alguns resultados já esperados — concentração de um pequeno número de gigantes mas uma “cauda longa” de milhares de trackers, prevalência desses mecanismos em sites de notícia, eficácia de extensões e plugins de bloqueio…

Mas Englehardt e Narayanan também fizeram algumas descobertas surpreendentes: a prática comum de “sincronização de cookies” entre diferentes trackers e a adoção de técnicas novas de fingerprinting para identificar dispositivos.

A capacidade de monitorar detalhadamente as ações das pessoas na Web, a prática difundida de compartilhar e vender dados umas para as outras e a característica desse mercado de possuir um pequeno número de empresas que estão presentes na maioria dos sites produzem um grave dano à privacidade de quem acessa a Web, afetando também outros direitos fundamentais como a autodeterminação e a inviolabilidade da intimidade.

Está tramitando na Câmara dos Deputados um Projeto de Lei que busca trazer garantias à população brasileira e que já têm paralelos em mais de cem países ao redor do mundo: uma lei que proteja os dados pessoais. Se aprovada da forma como foi proposto pelo Ministério da Justiça, ela estabelecerá claros limites em quais dados poderão ser guardados e processados por essas empresas com o objetivo explícito de proteger direitos fundamentais.

Neste artigo, vamos ver as principais descobertas do estudo de Englehardt e Narayanane entender como o Projeto de Lei nº 5.276/2016, resultado de duas consultas públicas e encaminhado à Câmara recentemente pelo governo Dilma Rousseff antes da presidenta ser afastada, pode nos dar maior controle sobre a coleta e o tratamento dos dados pessoais por parte dos trackers.

Third parties e trackers: data is money, my friend

Antes de tudo, uma definição: o estudo gira em torno das third parties. Quando visitamos um determinado site, a first party (“primeira pessoa”), ele pode carregar recursos como scripts e imagens de outros domínios, as third parties (“terceiras pessoas”).

milhaodesites-trackers

Muitos desses domínios servem trackers, enquanto outros são usados para fornecer imagens estáticas (como o gstatic.com da Google e o fbcdn.net do Facebook). Estes conteúdos não são relevantes para os propósitos do estudo, que analisa aqueles que hospedam scripts que rodam silenciosamente, detectam e comunicam à “base” informações sobre a visita. Para separar o joio do trigo, o estudo usou listas usadas por plugins de privacidade, curadas e alimentadas com novos endereços de trackers conforme eles são descobertos.
Para aprender mais sobre esse monitoramento funciona e como se defender dele, veja nosso artigo Trackers: os grandes stalkers da Web.

Descobertas do estudo

Embora tenham sido registradas 81.000 third parties, um pequeno grupo delas está presente em muitos sites, enquanto a maioria foi detectada em pouquíssimos sites (o “efeito cauda longa“). Isso confirma as impressões de observadores da indústria de que há uma grande concentração de grandes empresas do ramo que domina a maior parte do mercado — somente 123 dessas 81 mil estão presentes em mais de 1% dos sites, e todas as cinco maiores percentem à Google. “De fato, a Google, o Facebook e o Twitter são as únicas entidades com third parties presentes em mais de 10% dos sites”, dizem os autores.

Além disso, o estudo detectou que a maioria dos trackers faz sincronização de cookies (cookie syncing), comunicando a outros trackers os ID’s usados internamente para identificar visitantes. Esta descoberta sugere que as empresas de tracking trocam grandes volumes de seus dados entre si por fora da interação usuário(a)↔website .

Outra descoberta pouco óbvia é que a indústria de monitoramento online pode ser uma barreira para a ampla adoção de HTTPS. Como os navegadores alertam sobre “conteúdo misto” quando um site em HTTPS carrega recursos via HTTP desprotegido, e muitos trackers não oferecem por HTTPS (ou não por padrão), há um desincentivo para sites adotarem essa vital tecnologia para que suas visitas não sejam recebidas com um “cadeado quebrado”. Além dos riscos de interceptação, um outro agravante é que tais scripts de monitoramento e seus cookies, quando trafegam via HTTP, podem ser usados por agências de inteligência e crackers para te identificar e até invadir.

Sites de notícias e outros conteúdos editoriais são os mais monitorados. Já sites de universidades, organizações governamentais e sem fins lucrativos são os que menos instalam trackers. Uma hipótese levantada pelos autores é de que os últimos apresentam menos monitoramento (e anúncios) pois têm financiamento externo, enquanto os primeiros são obrigados a monetizar suas visitas (e, crescentemente, limitar visitantes que usam ad blockers).

Por que querem meus dados?


O caminho dos anúncios desde os marketeiros até você. Cada uma dessas empresas ajuda a definir quais você vai ver ao acessar uma página web.
“Informações pessoais são o novo petróleo, o combustível vital da nossa economia digital”, como disse Andrew Keen para a CNN. A vasta gama de tipos de dados que os aplicativos e dispositivos emitem constantemente — localização, relações sociais, hábitos de consumo e comportamento — são o que mantém o capital girando para uma grande e crescente parcela de empresas de software.

O modelo de negócios adotado nos primórdios da rede, com serviços pagos diretamente pelo cliente ou financiados por universidades e empresas, chegou ao público geral como o que os especialistas em privacidade e segurança da informação chamam de modelo de negócios da vigilância: a empresa oferece serviços “gratuitamente”, e paga suas contas e funcionários(as) vendendo as informações pessoais que conseguem coletar para quem se interessa.

Esses dados possuem alto valor para uma série de outras empresas que se beneficiam em conhecer detalhes sobre a vida das pessoas: serviços de crédito que querem avaliar seu risco de dar um calote, seguros de saúde que podem usá-los para determinar o valor do plano, lojas e empreendimentos que querem entender o comportamento do mercado e anunciar diretamente para um público-alvo específico…

Para intermediar a coleta de dados nos sites e aplicativos e seu uso final pelo mercado, surgiu a indústria das data brokers (“corretores de dados”). Gigantes como a Acxiom e a Experian possuem sedes ao redor do mundo, onde compram e vendem bancos de dados sobre populações inteiras.
O ramo é tão grande que muitas vezes há mais intermediários na cadeia: centenas de outras empresas pequenas e grandes comercializam entre si bancos de dados para integrar com sua vasta coleção — a Experian, que comprou a Serasa em 2007, possui terabytes de informação sobre o público brasileiro e petabytes a nível global.

Algumas das data brokers que coletam dados na Internet segmentam internautas com base no seu comportamento online, justamente através dos trackers estudados pela dupla de pesquisadores de Princeton. No Brasil, por exemplo, uma empresa chamada Navegg Analytics busca “entender o comportamento do consumidor”, e baseia sua segmentação da população em um estudo de 6 anos conduzido em mais de 100 mil sites. Seus scripts estão presentes na maioria dos portais de notícias e em vários outros sites voltados para o público brasileiro.


Algumas categorias em que a Navegg associa a você a cada visita em um site que use seus third-party scripts. Se você não tem tempo para ler nosso artigo sobre profiling, TEM QUE ao menos ler o guia ilustrado.

E agora, quem poderá nos defender?

tumblr_o85mhnFEZ51vwx6peo1_1280

O mercado de coleta e tratamento de dados em escala massiva, na ausência de leis que o limitem e por ser invisível para quem navega no site (tanto na coleta quanto no uso), se tornou definitivamente um monstro.
Proibi-lo completamente, no entanto, é desproporcional e eliminaria uma opção legítima de usar serviços gratuitos que, além de manterem-se financeiramente com o tratamento de dados, os usem para aprimorar sua interface e seu serviço — por exemplo coletando estatísticas de uso de seus softwares para entender quais entraves as pessoas enfrentam.

O que precisamos para tornar essa indústria mais justa e saudável são ferramentas para que as pessoas possam exercer controle sobre que dados vão compartilhar e entendendo o que está em jogo após suas escolhas.

Proteções legais aos nossos dados com o Projeto de Lei 5276/2016, além de eficazes no cenário atual de trackers, protegem todos os dados, quer sejam visitas em sites, quer sejam suas compras no supermercado. Ele também traz limites claros não só para o momento da coleta como o de tratamento (pense em algoritmos) e o repasse para o poder público ou empresas dentro e fora do país. O PL também obriga as empresas a seguir padrões e boas práticas de segurança para o armazenamento, a transmissão e a anonimização (que serão atualizados conforme as tecnologias de proteção e de quebra evoluem).

O PL 5276/2016 protege seus dados

tumblr_o8d35aEnVm1vwx6peo1_500
Segundo Marília Monteiro, pesquisadora do Privacidade Brasil e mestranda em Políticas Públicas na Hertie School of Governance, “há pouca, senão nenhuma regra que regule a atividade dos chamados data brokers no Brasil. Para aquelas que lidam com informações de crédito, algumas balizas estão presentes nas regras consumeristas, mas isso está limitando a alguns agentes da cadeia de informações de crédito e não de forma sistemática e especializada”.

Nós da Coding Rights, junto com mais 40 entidades da academia e da sociedade civil organizada manifestamos interesse na chegada do Projeto de Lei de Proteção de Dados Pessoais à Câmara dos Deputados. O PL nº 5.276/2016, como escrevemos em uma carta aberta, “foi construído de forma colaborativa com amplo engajamento social por meio de duas consultas públicas realizadas no fim do ano de 2010 e começo do ano de 2015, a partir da iniciativa do Ministério de Justiça em colocar o texto do então Anteprojeto de Lei de Proteção de Dados Pessoais sob escrutínio público nas plataformas online Cultura Digital e Pensando o Direito“.

O PL de Proteção de Dados vem preencher uma lacuna na nossa legislação: proteções semelhantes já existem na maioria das democracias mais fortes do mundo, como a Diretiva de Proteção de Dados que orienta as leis de cada país da União Europeia, ou as regulamentações específicas por setor que os EUA adotam em vez de uma lei geral. Marília Monteiro, que era coordenadora de Consumo e Sociedade da Informação da Senacon/MJ e participou ativamente da elaboração do debate público, afirma que “o PL 5.276/16 traz padrões mínimos internacionalmente reconhecidos que criam o dever de transparência para as data brokers. Os princípios, direitos e garantias presentes no projeto permitiriam, por exemplo, que os usuários acessem as informações agregadas pelas data brokers, optem pela não coleta, compartilhamento e divulgação de seus dados pessoais e que corrijam as informações a seu respeito”.
Como vimos, há uma grande concentração de atores no mercado de tracking, o que torna uma lei que estabeleça normas para sua atuação mais eficiente. Segundo os autores, “para as pouco mais de 100 third parties que são prevalentes em pelo menos 1% dos sites, imaginamos que elas são entidades grandes o bastante para terem seu comportamento regulamentado por pressão da opinião pública e a possibilidade de ações legais”.
Ao longo dos últimos meses, viemos preparando uma série de materiais para auxiliar a participação no processo de consulta pública. No guia Dados Pessoais: como contribuir para o debate público, feito pela Oficina Antivigilância e pelo CSLab, são explicados os principais conceitos e questões de cada um dos “eixos” do debate conforme organizado pelo Ministério da Justiça. Fizemos um boletim especial com artigos sobre as data brokers e os riscos e garantias da anonimização na proteção de dados pessoais, além de uma visualização interativa dos comentários feitos na plataforma do MJ para enxergar as principais disputas em torno do texto da lei.

Exercendo (algum) controle sobre sua navegação

Enquanto não temos uma lei que nos proteja, podemos exercer um maior controle sobre os dados que entregamos para estas empresas através das já conhecidas ferramentas de bloqueio de anúncios. O estudo dos pesquisadores de Princeton realizou testes comparados com um navegador com Ghostery, e verificou que ele é bastante eficiente, bloqueando grande parte dos trackers sem comprometer o funcionamento normal do site (deixando passar domínios de CDN’s e e widgets, por exemplo).
As extensões Privacy Badger (Chrome, Firefox)  e uBlock Origin (Chrome, Firefox, Opera) possuem um funcionamento similar ao Ghostery, com a vantagem de serem software livre. A combinação das duas é nossa recomendação para proteger sua navegação dos olhos da indústria de forma transparente e automática. Estas ferramentas atuam através de “listas negras” e sistemas sofisticados de reconhecimento de tracking para impedir o navegador de carregar scripts enxeridos.


Comparação feita para nosso artigo sobre trackers mostra scripts carregados sem (1ª) e com (2ª) as extensões Privacy Badger e uBlock Origin. Muitos deles atuam em vários sites ao mesmo tempo.

Fingerprinting, ou seguindo você na Internet sem login

Apesar de haver ferramentas que bloqueiam os trackers tradicionais, o estudo detectou uma série de métodos pouco conhecidos ou até inéditos de monitorar pessoas online, que passam batido por essas extensões.
milhaodesites-fingerprinting
As técnicas de fingerprinting permitem que o tracker faça uma “impressão digital” de todos os dados que consegue juntar sobre o navegador; assim, ele sabe que quem está entrando no site X é a mesma pessoa que entrou em um site Y. Seguindo sua trajetória online é possível aprender muito sobre seu comportamento mesmo sem saber sua identidade pessoal — e basta fazer login em um site onde você tenha se cadastrado e puf, já é possível te ligar ao seu histórico de navegação.

Alguns métodos de fingerprinting já são conhecidos: a lista de fontes e plugins que o navegador suporta, as informações sobre a versão do navegador (user agent string) e o tamanho de sua janela… a ferramenta Panopticlick mantida pela EFF testa o quão único é seu navegador frente aos das outras milhares de visitas que o site já ganhou.

Uma gama de outras formas de fingerprinting são menos conhecidas e estudadas. O canvas fingerprinting, por exemplo, se aproveita de particularidades na forma como o javascript desenha formas no <canvas> em diferentes dispositivos e navegadores. A pesquisa de Englehardt e Narayanan é a primeira a detectar uma série de métodos sofisticados de identificação que se aproveitam de interações com o sistema que o javascript oferece sem pedir permissão:
  • Font canvas fingerprinting é enumerar as fontes presentes no sistema através da interface “canvas” de desenho.
  • O WebRTC-based fingerprinting coloca na mistura seu endereço de IP na rede local.
  • O AudioContext fingerprinting detecta sutilezas na forma como a Audio API processa sinais de áudio em cada máquina e navegador.
  • Foram detectados até scripts que gravam o nível de bateria e quanto falta para (des)carregar completamente.
A princípio, estas informações parecem banais e inúteis. No entanto, é consenso na comunidade técnica e na ciência da computação que até mesmo poucos dados que se refiram aos hábitos ou comportamentos de uma pessoa, quando combinados, podem identificá-las com alta precisão, ou destacá-las na multidão com base em características coletivas como etnia, situação econômica, condição de saúde e posições políticas.

Como disse Arvind Narayanan em seu site pessoal dedicado à (des)anonimização de dados, “há somente 6,6 bilhões de pessoas no mundo, então são necessários somente 33 bits de informação sobre uma pessoa para determinar quem ela é”. O cenário só piora na Web, já que o número de pessoas com acesso à rede é muito menor que a população mundial, e 15 minutos de navegação podem facilmente revelar todos os bits necessários para revelar nossa identidade.

Entramos em contato com Cooper Quintin, desenvolvedor da extensão Privacy Badger, para entender o quanto a extensão já nos protege contra as técnicas abordadas no estudo. Em vez de usar uma lista de trackers conhecidos, o software mantido pela Electronic Frontier Foundation busca em todas as third parties comportamentos associados ao monitoramento, como o armazenamento de cookies e acesso às funcionalidades do javascript que fornecem dados para fingerprinting. Assim, aprimorar a heurística do software para novas ameaças protege automaticamente milhares de usuários(as) da extensão na próxima atualização.

Para Cooper, o relatório da dupla de Princeton é “fascinante”, e ele planeja examiná-lo com mais calma para adaptar seu software aos novos métodos descobertos. “Font canvas e AudioContext são definitivamente novos para mim, e não são detectados pelo Privacy Badger. No momento atual detectamos canvas fingerprinting e super cookies de armazenamento local, além dos cookies tradicionais”.


No próximo artigo da Oficina Antivigilância para a campanha #ProtejamMeusDados, veremos como o PL 5.276/2016, através de suas determinações sobre anonimização de dados e dados usados para formação de perfis (profiling) nos protege de práticas abusivas de publicidade e riscos severos de segurança que a reidentificação apresenta para todos(as), dentro e fora da Web (spoiler: será baseado no nosso artigo sobre anonimização).

Os especialistas em proteção de dados pessoais Bruno Bioni e Renato Leite Monteiro fizeram uma instrutiva linha do tempo dos PLs de Proteção de Dados Pessoais para o Data Privacy Brasil. Você pode acompanhar a tramitação do PL no site da Câmara; é possível se cadastrar para receber atualizações por e-mail.
O InternetLab fez uma análise detalhada de todo o debate feito na última consulta pública, sendo um ótimo guia para se aprofundar em questões específicas como consentimento, dados anônimos, transferência internacional, e o tratamento de dados para segurança pública e defesa nacional.

pldadospessoais

Você pode se envolver pelo Twitter , Facebook e nas suas redes de preferência — memes e materiais de divulgação estão sendo organizados no Tumblr PL 5276 protege nossos dados!. Na página especial #ProtejamMeusDados que preparamos aqui no site, manteremos uma visão geral da campanha e do processo no Congresso.

Oficina Antivigilancia

sábado, 21 de maio de 2016

WhatsApp libera Video Call na versão beta para Android


whatsapp-video-call whatsapp-video-call-2

A última versão Beta do WhatsApp, liberada para o Android, incorpora um novo recurso de ligações por vídeo.

A funcionalidade de Video Call pode ser encontrada na compilação Beta (v2.16.80) do WhatsApp que está disponível no Google Play.

Agora, ao fazer uma ligação, o usuário recebe o aviso de duas opções: uma para ligação por áudio e outra por vídeo (veja os detalhes nas imagens abaixo).

Embora já seja possível visualizar a nova função, ainda não é possível realizar qualquer chamada neste momento, provavelmente devido a um bloqueio “server-side”.

Créditos das imagens para Reinaldo Versuri

Via Discovery

sábado, 19 de março de 2016

Bots : Cuidado com eles e como checar informações

As pessoas interessadas em distorcer informações para favorecer objetivos pessoais ou institucionais estão usando recursos cada vez mais sofisticadas, o que obriga os jornalistas a serem também mais sofisticados na identificação da manipulação de notícias.

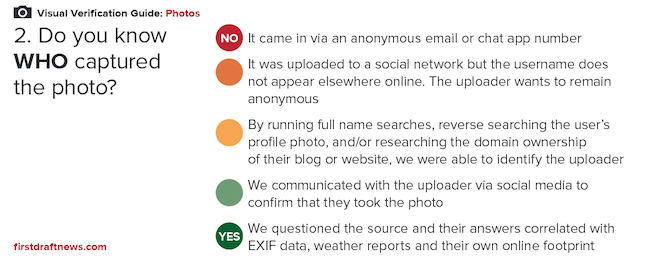
Checar suas fontes é fundamental para qualquer investigação online. Quando você encontra vídeos ou imagens irresistíveis, chegar ao “quem” as fez ou de “onde” vieram é essencial. E os Guias de Checagem Visual do First Draft News fornecem uma excelente visão de conjunto dos itens que devem ser levados em consideração quando se pretende checar uma fonte. Há guias especiais para checagem de fotos e para vídeos.

Reprodução de uma página do guia de verificação de fotos suspeitas

Reprodução de uma página do guia de verificação de fotos suspeitas

O cenário ideal, evidentemente, é poder falar diretamente com uma fonte, se possível, pelo telefone ou pessoalmente. Mesmo assim, podem ocorrer erros, principalmente quando a fonte está fingindo ser alguma coisa ou alguém que não é. Muitas vezes, essas pessoas são apenas farsantes, mas há uma tendência crescente de casos de pessoas que usam identidade falsa para fins fraudulentos [sockpuppets]: identidades falsas online criadas para atrapalhar determinadas pautas políticas ou sociais.

No entanto, as fontes podem não responder quando você tenta falar com elas. Talvez estejam ocupadas, ou talvez não queiram falar com jornalistas. Outro motivo poderia ser que a sua fonte que a sua fonte não seja uma pessoa coisa nenhuma: muitos casos que acontecem em redes sociais são bots [softwares concebidos para simular ações humanas repetidas vezes de maneira padrão, da mesma forma que o faria um robô].

Sockpuppets e bots colocam alguns desafios interessantes para checagem, principalmente em regiões do mundo onde governos os usam para manipular redes sociais (e isso significa uma parte do mundo maior do que você poderia imaginar) e sabendo como localizá-los pode poupar tempo e esforços.

Localizando um bot
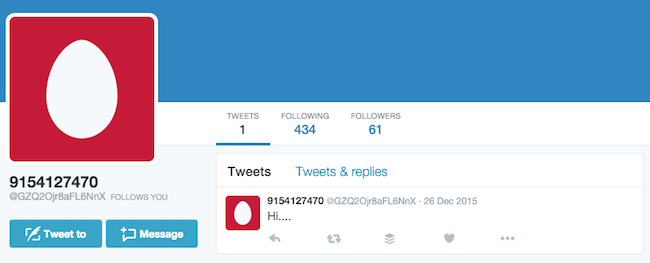
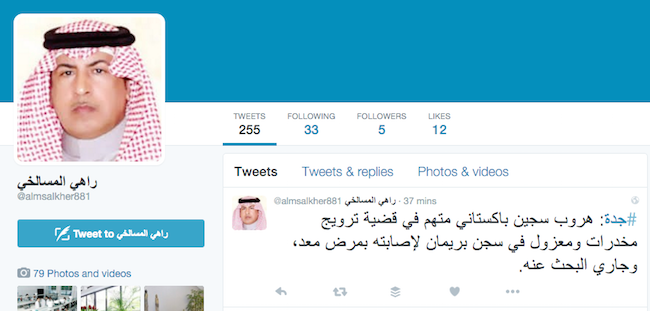
Expor um caso de um bot pode ser de uma facilidade trivial ou ilusoriamente difícil. Veja, por exemplo, estas duas contas do Twitter:

bots verificação site arabe
bots verificação foto arabe 2
No caso do primeiro usuário, inúmeras bandeiras vermelhas aparecem instantaneamente. O nome incompreensível do usuário, a foto do perfil do Twitter com um ovo, o único e breve tweet – este usuário rapidamente se choca com as principais dicas para localizar contas falsas do First Draft.

No entanto, a segunda conta, cujo último tweet fala de um preso paquistanês que fugiu de uma prisão em Gidá, na Arábia Saudita, é um desafio mais importante. Um número razoavel de seguidores (embora poucos) , uma boa amostragem de tweets, uma foto da pessoa real no perfil, nomes de usuário e de visualização aparentemente corretos e um conjunto de conteúdos (incluindo foto e vídeo) numa linguagem que poderíamos esperar. Precisamos trabalhar um pouco mais.

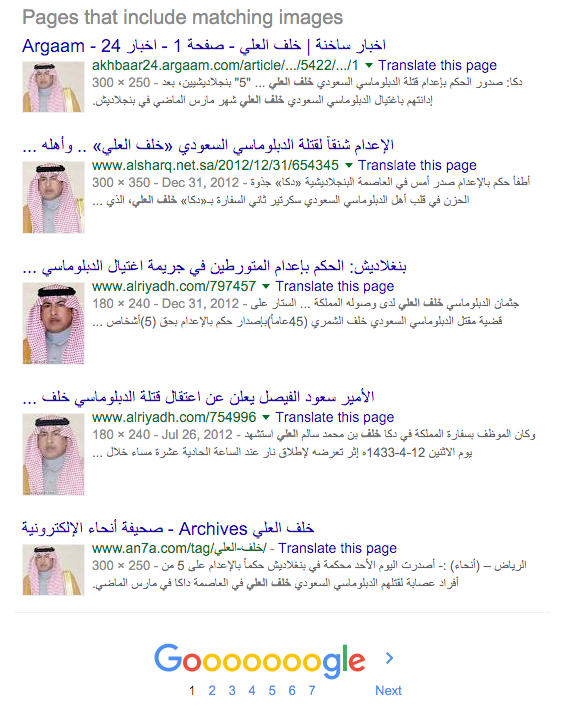
Primeiramente, vamos checar a foto do perfil. Trata-se de uma imagem original? Tentemos fazer uma busca reversa das imagens :
bots verificação foto arabe 3
Reprodução da página do Google especializada na pesquisa de imagens
Uma bandeira vermelha que surge imediatamente sugere que a foto do perfil seja, na verdade, de um homem chamado Khalaf Al-Ali, um diplomata saudita assassinado em Bangladesh em 2012. Portanto, talvez este usuário tenha postado sua imagem como uma recordação do diplomata. Continuemos investigando.

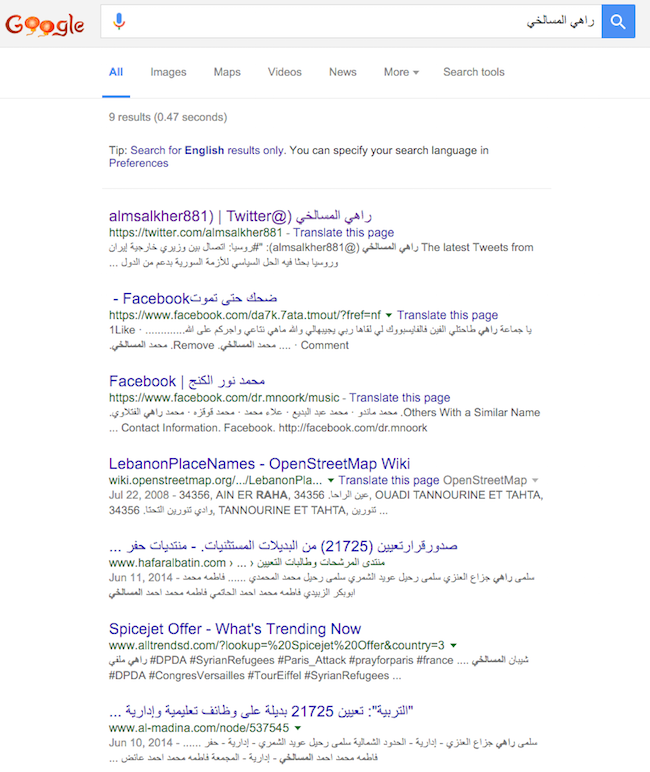
O segundo passo é ver se conseguimos encontrar uma pessoa chamada Rahi Al-Msalkhe procurando no Google pelo seu nome no idioma árabe.
bots verificação de fotos arabe 4
Qual o objetivo dos bots?

Não há qualquer retorno senão a conta do Twitter que estamos investigando e outra bandeira vermelha. Talvez esta pessoa tenha posto um nome falso na conta? Não é tão incomum.

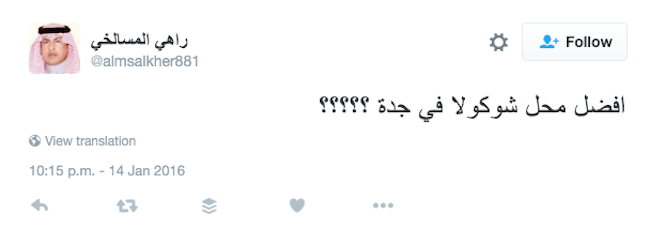
Como terceiro passo, examinemos com mais cuidado os tweets da conta. Parecem ser, em sua maioria, compartilhamento de links no idioma árabe com dois ou três tweets em inglês. Nada de extraordinário. Após uma breve busca, este tweet parece o mais pessoal e possivelmente dá uma localização:
bots verificação foto arabe 5
Tradução: “Qual é a melhor loja de chocolate em Gidá?????”
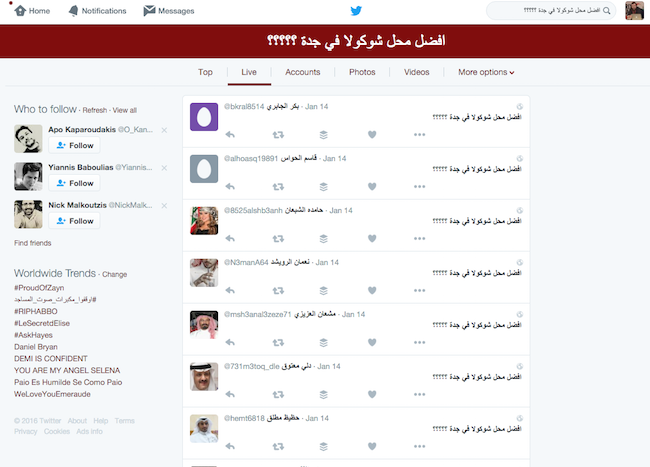
É uma boa pergunta, mas parece que ninguém respondeu. Vejamos se alguém mais fez a mesma pergunta no Twitter.
bots verificação foto arabe 6

Puxa vida! Parece que às 22:15 (horário da Costa Oeste dos Estados Unidos) do dia 14 de janeiro, cerca de 100 contas fizeram exatamente o mesmo tweet.
É difícil imaginar uma situação em que isso acontecesse na vida real e, se repetirmos a busca em dois outros tweets de @almsalker881, descobriremos que se trata de um padrão repetido. 

A esta altura, podemos dizer com segurança que, na melhor das hipóteses, esta conta está comprometida e que muito provavelmente se trata de um bot. Ao clicar em qualquer das contas que tenha feito tweets do conteúdo duplicado, obtemos resultados semelhantes.

Qual será o objetivo deste exército de bots? Desconhecendo quem está por trás dele, é difícil dizer. Mas algumas das maneiras que já vimos contas serem usadas por bots e sockpuppets foram para mandar mensagens não desejadas pela internet e para caluniar ativistas, para apagar hashtags e criticar autoridades e para disseminar desinformação.

Consciência das possibilidades

Esses esforços por parte de Estados podem ser mais elaborados do que você imagina. Em 2015, o repórter Adrian Chen, do New York Times, publicou uma matéria fascinante com uma visão aprofundada de uma “fábrica de trolls” russa [um departamento aparentemente voltado para disseminar notícias e opiniões pró-Putin nas redes sociais]. Chen rastreia algumas campanhas de desinformação extremamente complexas que o levam de volta à fábrica de trolls. Num exemplo, autoridades e moradores de uma cidade no estado de Louisiana receberam mensagens com advertências sobre uma explosão numa fábrica química e a disseminação de vapores tóxicos. 

Pelo Twitter, dúzias de contas começaram a enviar mensagens sobre a explosão, citando jornalistas importantes com screengrabs [captura de tela] da CNN.com mostrando as notícias “em cima da hora”. Surgiram vídeos mostrando imagens semelhantes às do Estado Islâmico em que era reivindicada a responsabilidade pela explosão.

Rapidamente, apareceu uma página na Wikipedia descrevendo a explosão e fazendo o link entre os vídeos. Tudo isto era falso, inclusive clones que funcionavam como websites do noticiário local e divulgavam a matéria. Esse ataque de desinformação fez-se seguir por outros, também explorando medos públicos muito concretos, como o #EbolaInAtlanta and #shockingmurderinatlanta.

Embora seja improvável que encontremos campanhas de desinformação tão bem coordenadas em termos diários e constantes, é extremamente importante que os jornalistas fiquem atentos para as proporções em que a coleta de dados sociais pode ser manipulada e gozem de alguns truques e ferramentas que os ajudem a localizar os bots.

Uma ferramenta útil para localizar bots é a BotOrNot, criada pelo projeto Truthy. BotOrNot analisa uma série de características de uma conta para lhe dar uma avaliação sobre se a conta parece um bot, o que inclui a rede, o usuário, “amigos”, temporal, conteúdo e análise de sentimentos.
BotOrNot não é perfeito (acerta apenas em 31% dos casos de um bot selecionado), mas pode proporcionar percepções úteis sobre contas a que, de outra maneira, não teríamos fácil acesso.

A rede social está apenas saindo da infância e a internet, na qual ela vive, tem apenas 20 anos em termos de acesso público. Os atores políticos utilizarão todos os meios possíveis para disseminar suas mensagens e, portanto, é crucial que os jornalistas tenham consciência das possibilidades e as saibam identificar.

Verifique o site Sock puppets and spambots: How states manipulate social networks e outras leituras e recursos sobre checagem.
***

Via Observatório da Imprensa com Tom Trewinnard do Meedan Labs